Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de Visión por Computador y AR, Investigador PhD
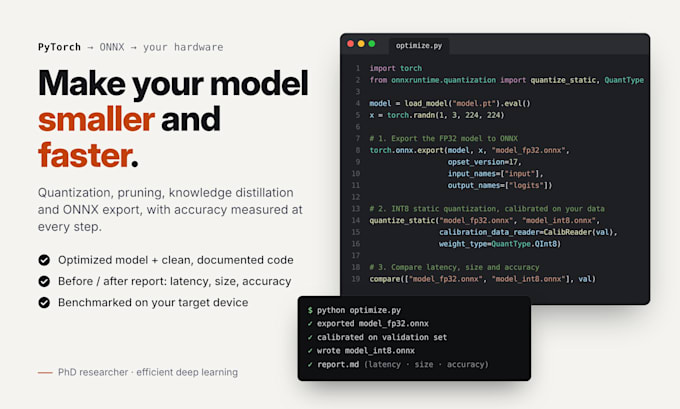
¿Tu modelo de PyTorch es demasiado lento, demasiado grande o demasiado caro para ejecutar en producción? Soy investigador de doctorado en visión por computadora con publicaciones revisadas por pares sobre compresión de modelos y distilación de conocimiento. Haré que tu modelo sea más pequeño y rápido sin perder precisión en exceso.
Lo que puedo hacer:
Lo que obtendrás:
Por favor, envíame un mensaje antes de hacer el pedido con la arquitectura de tu modelo, la versión del framework, el hardware objetivo (GPU, CPU, Jetson, móvil) y tu presupuesto de precisión, para poder confirmar el paquete correcto.
Lenguaje de programación:
Python
•
Colab
Herramientas:
Jupyter Notebook
•
opencv
•
PyTorch
Marcos:
keras
•
PyTorch
Traducción automática
¿La optimización reducirá la precisión de mi modelo?
Algunas técnicas pueden reducir ligeramente la precisión. Acordamos un presupuesto de precisión antes de empezar, mido cada paso y obtendrás números antes/después, así no habrá sorpresas.
¿Qué modelos y frameworks soportas?
Principalmente modelos de visión en PyTorch: clasificación, detección, segmentación y tareas similares. Los modelos de TensorFlow/Keras a menudo se pueden manejar a través de ONNX. Si tu modelo es inusual, envíame un mensaje primero y te diré con franqueza si puedo ayudar.
¿Necesitas mis datos de entrenamiento?
La cuantización y la exportación a ONNX solo requieren un conjunto pequeño de calibración/validación. Distilación y ajuste fino necesitan acceso a datos de entrenamiento. Tu modelo, código y datos se mantienen confidenciales y no se reutilizan.
¿Qué hardware pruebas?
Hago benchmarks en GPUs NVIDIA RTX (TensorRT, ONNX Runtime GPU), CPUs x86, Macs con Apple Silicon y teléfonos Android. Para Jetson u otras placas edge entrego el modelo exportado más un script de benchmark que puedas ejecutar, o pruebo con el acceso que des.
¿Qué recibo exactamente?
Los archivos de modelo optimizados (por ejemplo ONNX o un motor TensorRT), código Python limpio que reproduce cada paso y un informe corto con latencia antes/después, tamaño del modelo y precisión.
