Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
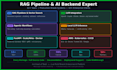
Ingeniero de backend de IA | Pipelines RAG · Integración de LLM · Sistemas agenticos
Soy un ingeniero de software senior con más de 12 años creando sistemas de IA en producción. Soy el único arquitecto de Teqit, una plataforma empresarial en vivo con pipelines RAG, inferencia de LLM en local y microservicios agenticos que atienden a más de 10 clientes.
Lo que puedo construir para ti:
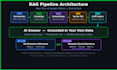
- Pipelines RAG para ingestión de documentos, búsqueda vectorial, generación de respuestas con LLM
- Integración de API de LLM con OpenAI, Claude, Gemini o cualquier modelo alojado
- Inferencia local de LLM con Ollama / llama.cpp (reducción de costos de IA en aproximadamente un 70%)
- Flujos de trabajo agenticos con llamadas a herramientas, razonamiento en múltiples pasos, pipelines de decisiones
- Backends con FastAPI o Scala mediante REST o gRPC
- Enrutamiento híbrido con cambio inteligente entre modelos locales y en la nube
¿Por qué yo?
He hecho esto en producción real, no en tutoriales. He reducido los costos de IA en un 70% con inferencia local, creado pipelines de avatares generativos en video y diseñado agentes que razonan de forma independiente sobre bases de conocimientos empresariales.
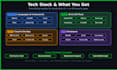
Tecnologías: Python · FastAPI · Ollama · API de OpenAI · Akka/Scala · Docker · AWS
Envíame un mensaje antes de ordenar, revisaré tu caso de uso primero.
Senior AI and Backend Engineer
Idiomas
Traducción automática
Traducción automática
¿Puedes usar mis propios documentos como base de conocimientos?
Sí — PDFs, documentos Word, archivos de texto o bases de datos. Me encargo de toda la ingesta y el pipeline de fragmentación.
¿Puedo alojarlo en mi propio servidor o en AWS?
Por supuesto. Configuro despliegues con Docker + AWS EC2 y puedo ajustarlo para cualquier proveedor de nube.
¿Necesito una clave API de OpenAI?
Solo si quieres modelos en la nube. Para inferencia local usando Ollama, no se necesita clave API externa.
¿Compartirás el código fuente?
Sí — se entrega código fuente completo con documentación para todos los paquetes.
¿Puedes integrar esto en mi app existente?
Sí, siempre que compartas las especificaciones de API o acceso al código base. Envíame un mensaje primero para discutir tu configuración.


