Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
¿Necesitas un modelo de aprendizaje automático que realmente funcione con tus datos, no solo en un cuaderno?
Soy un Data Scientist con un MSc en Data Science (Reino Unido) que construye, evalúa y despliega modelos ML en Python. Me concentro en resultados en los que puedas confiar: datos limpios, pruebas sin filtraciones y las métricas correctas para tu problema.
LO QUE PUEDO CONSTRUIR PARA TI
- Predicción de abandono de clientes
- Pronósticos de ventas y demanda
- Modelos de clasificación y regresión
- Agrupamiento y segmentación de clientes
- Detección de anomalías
- Aplicaciones web en vivo o APIs para tu modelo (Premium)
LO QUE RECIBES
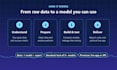
- Limpieza de datos y análisis exploratorio
- Modelo construido con Scikit-learn, XGBoost o TensorFlow/Keras
- Informe de resultados claro en un lenguaje sencillo
- Código fuente completo en Python y cuaderno Jupyter
TRABAJOS RECIENTES
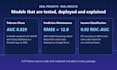
- Modelo de abandono en telecomunicaciones: 4 modelos comparados, AUC 0.829, desplegado en AWS
- Mantenimiento predictivo: motor de predicción de fallos en Google Cloud usando GRU
- Clasificador de ingresos: 87% de precisión, ROC-AUC 0.92
Por favor, envíame un mensaje ANTES de ordenar con una breve descripción de tus datos y tu objetivo, para poder confirmar el paquete adecuado para ti.

Lenguaje de programación:
Python
•
R
•
SQL
•
Colab
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Otros
Herramientas:
Jupyter Notebook
•
TensorFlow
•
Colab
•
RStudio
Traducción automática
¿Qué necesitas de mí para empezar?
Tu conjunto de datos (CSV, Excel o exportación de base de datos), una breve descripción de lo que quieres predecir y cualquier preferencia de plazo o herramienta. Si tus datos aún no están listos, envíame un mensaje y te ayudaré a planear qué recopilar.
¿Qué paquete debo elegir?
Básico si necesitas probar un modelo en un conjunto de datos. Estándar si quieres lo mejor de varios modelos, ajustados y explicados. Premium si necesitas que el modelo funcione como una aplicación en vivo o API que tu equipo pueda usar.
¿Puedes garantizar una precisión específica?
Ningún científico de datos honesto puede garantizar precisión antes de ver los datos, porque depende de la calidad de los datos y de qué tan predecible sea el problema. Te diré desde temprano qué resultados parecen realistas y siempre reporto resultados en datos de prueba no vistos, no en puntuaciones infladas de entrenamiento.
¿Obtendré el código fuente?
Sí. Cada paquete incluye el código fuente completo en Python y un cuaderno Jupyter, así que tienes todo y puedes volver a ejecutar o ampliar el modelo.
¿Mis datos se mantienen confidenciales?
Sí. Uso tus datos solo para tu proyecto, nunca los comparto y los elimino después de la entrega si me lo pides. Estoy dispuesto a firmar un NDA.


