Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
Tu chatbot RAG parecía estar bien en la demo. Luego los usuarios reales empezaron a hacer preguntas reales y ahora da respuestas incorrectas con total confianza.
Normalmente el problema no es el modelo. Es la recuperación, el chunking o el texto que salió de OCR dañado. Descubro cuál es, con números en lugar de conjeturas.
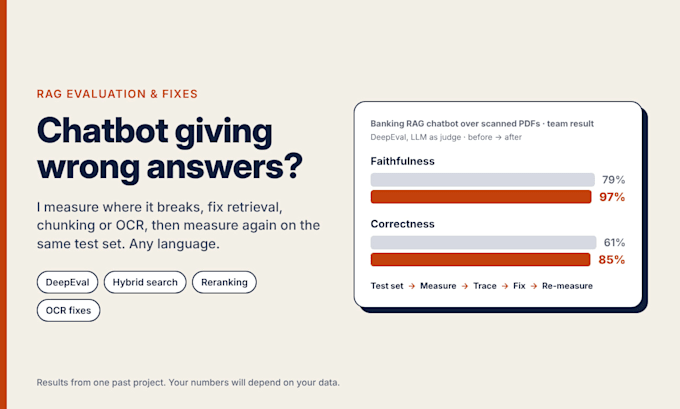
Este es el trabajo que mejor manejo. En un chatbot de banca sobre PDFs escaneados en GBG, medimos fidelidad en 79%. Después de arreglar OCR y añadir búsqueda híbrida, re-ranking y reescritura de consultas, llegó al 97% y la exactitud pasó de 61% a 85% (DeepEval, LLM como juez).
Cómo funciona:
1. Construyo un conjunto de pruebas a partir de tus documentos y preguntas reales de usuarios
2. Califico fidelidad, exactitud y calidad de recuperación
3. Trazo cada fallo hasta su causa: parsing, chunking, búsqueda, ranking o prompt
4. Recibes un plan de corrección, o hago las correcciones y lo vuelvo a calificar
Obtienes un informe corto con números antes/después en el mismo conjunto de pruebas. No prometo un número específico, ya que depende de tus datos.
Funciona con LangChain, LlamaIndex o pipelines de Python simples, en cualquier idioma en que estén tus documentos.
Envíame unos ejemplos de respuestas malas. Eso suele ser suficiente para que te diga dónde miraría primero.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Idiomas
Traducción automática
Traducción automática
¿Necesitas acceso a mi código?
Para la auditoría, basta con un endpoint de API funcionando o acceso de lectura. Para realizar las correcciones necesito el código, idealmente un repositorio privado de Git al que me invites. No necesito contraseñas de producción.
¿Puedes prometer un número de precisión específico?
No, y tendría cuidado con quien sí lo haga. Depende de tus documentos y preguntas. Lo que prometo son puntuaciones honestas antes/después en el mismo conjunto de pruebas, para que veas exactamente qué mejoró.
¿Qué herramientas usas para la evaluación?
Principalmente DeepEval con un juez LLM, más comprobaciones de si se recuperaron los trozos correctos. Si ya usas RAGAS o tu propia configuración, puedo trabajar con eso.
¿Importa el idioma de mis documentos?
El proceso es el mismo. El idioma afecta principalmente al OCR, a la segmentación de texto y a la calidad de la búsqueda, y verifico esas partes específicamente. He trabajado mayormente con árabe e inglés. Dime el tuyo y te diré con honestidad si encaja.
¿Qué pasa si la corrección real es una arquitectura diferente?
Entonces el informe lo dirá, con una estimación aproximada, antes de escribir cualquier código. Tú decides qué sucede después.
