Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero de datos
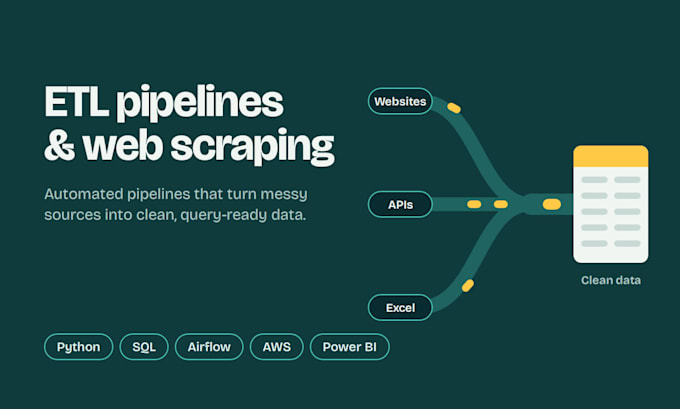
¿Necesitas datos de sitios web, o tienes datos pero sin un sistema fiable para moverlos? Hojas de cálculo, APIs y bases de datos que nunca cuadran, informes reconstruidos a mano cada semana, pipelines que se rompen de la noche a la mañana? Yo soluciono eso.
Soy ingeniero de datos con 4 años de experiencia y un MSc en Big Data Analytics del Reino Unido. Actualmente, construyo pipelines de producción para grandes marketplaces en línea, incluyendo tablas de hechos incrementales en Redshift de más de 20 millones de registros.
Lo que construyo:
Por qué yo: experiencia real en producción, código limpio y documentado que tú posees, y actualizaciones claras en cada paso.
Por favor, envíame un mensaje antes de hacer el pedido para poder definir adecuadamente tu proyecto.
Traducción automática
¿Con qué herramientas trabajas?
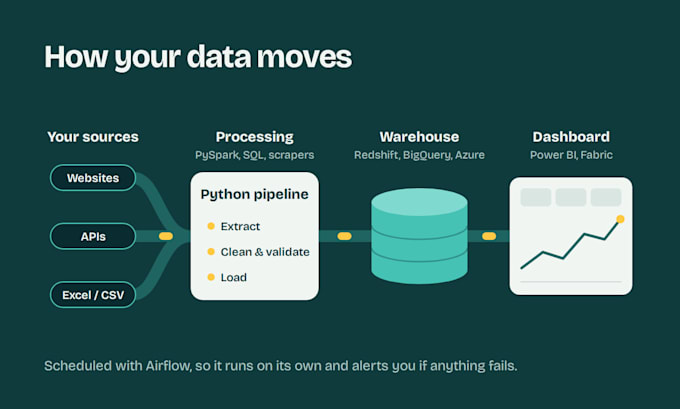
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery y Power BI, además de BeautifulSoup, Requests, Selenium, Scrapy y Playwright para web scraping.
¿Puedes raspar sitios web que cargan contenido con JavaScript?
Sí. Para sitios dinámicos uso herramientas de automatización de navegador como Selenium o Playwright en lugar de simples solicitudes de página.
¿Puedes trabajar con mi pipeline existente?
Sí. Puedo depurar, optimizar o ampliar pipelines que ya tengas, incluyendo arreglar duplicados o registros faltantes.
¿En qué formato recibiré mis datos?
CSV, Excel, JSON, Google Sheets o cargados directamente en tu base de datos o data warehouse.
¿Soy dueño del código?
Sí. Obtienes el código fuente completo, y Standard y Premium también incluyen documentación.
¿Puedes hacer scraping de cualquier sitio web?
Solo raspo datos disponibles públicamente. No raspo redes sociales ni nada que requiera inicio de sesión sin permiso, ya que va contra las normas de Fiverr.
¿Puedes construir pipelines en tiempo real?
Los pipelines por lotes programados son mi oferta principal. Para necesidades en tiempo real, escríbeme primero y verificaremos si se ajusta.