Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
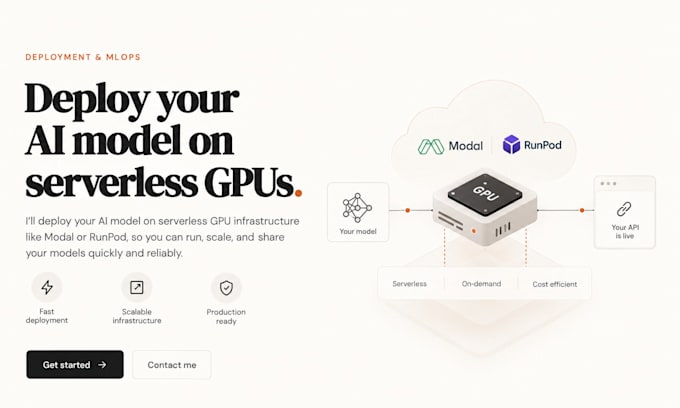
Construyo y optimizo backends de inferencia de IA para aplicaciones que necesitan un cálculo real en GPU, no solo una envoltura alrededor de la API de ChatGPT.
He desplegado y optimizado pipelines de IA en producción (procesamiento de imágenes/video, modelos generativos de estilo face-swap) en la infraestructura serverless de GPU de Modal, incluyendo:
- Configuración de instancias GPU/CPU (L4/T4) ajustada para equilibrar costo y latencia
- Optimización de cold-start y calentamiento para reducir segundos de GPU desperdiciados
- Captura de instantáneas de memoria GPU para disminuir el tiempo de cold-start
- Optimización de pipeline con una reducción de aproximadamente el 75% en el tiempo de procesamiento en una carga de trabajo en producción
- Manejo de señales y correcciones de fiabilidad para trabajos de inferencia de larga duración
Mobile App Developer
Idiomas
Traducción automática
