Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador en Python, experto en Web Scraping y análisis de datos
¿Necesitas datos de preguntas y respuestas limpios y estructurados para ajustar o entrenar un modelo de AI/LLM?
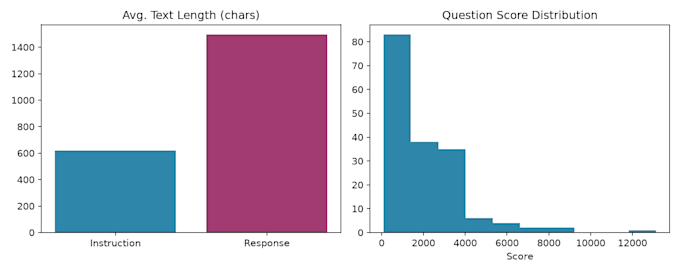
Construyo pipelines de recolección de datos que extraen pares de preguntas y respuestas de fuentes públicas basadas en API (no scraping frágil de HTML), limpian el texto, filtran contenido de baja calidad o que contiene PII, y entregan JSONL de instrucciones/respuestas listo para usar en el formato exacto que se usa para ajustar modelos como GPT y Llama.
Lo que obtienes:
Utilizo APIs públicas oficiales en lugar de scrapear sitios que lo prohíben (como Reddit/Quora), así que tu conjunto de datos es limpio, legal y confiable.
Indícame tu tema/dominio y cuántos registros necesitas, y confirmaré el alcance antes de que hagas el pedido.

Experiencia:
Otros
Lenguaje de programación:
Python
Herramientas:
Jupyter Notebook
Traducción automática
¿De qué fuentes recopilas?
APIs públicas documentadas (por ejemplo, Stack Exchange) que permiten explícitamente este tipo de recopilación — no plataformas que prohíben el scraping.
¿En qué formato se entrega la información?
JSONL (pares de instrucción/respuesta), el formato estándar para ajuste fino de LLM. También disponible en CSV/JSON bajo solicitud.
¿Puedes hacer un tema/dominio personalizado?
Sí — envíame tu tema y la cantidad de registros objetivo antes de ordenar para que pueda confirmar la viabilidad.