Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Especialista en Machine Learning, NLP
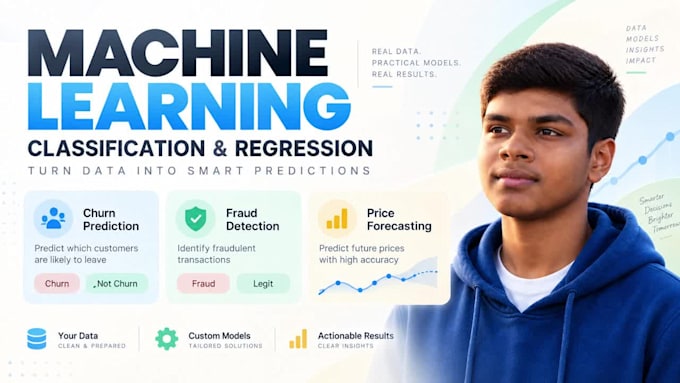
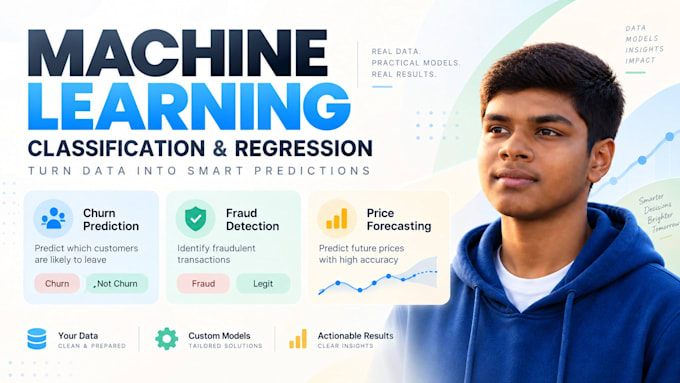
¿Necesitas un modelo de machine learning confiable para clasificación, regresión o predicción?
Portafolio: https://kawsar-portfolio-kawsar07ahmmed0712-5454.vercel.app/
Construyo soluciones de machine learning limpias y prácticas para datos estructurados y tabulares usando Python.
En qué puedo ayudarte:
Herramientas que uso:
Scikit-learn, XGBoost, LightGBM, CatBoost, Pandas, NumPy, Jupyter Notebook y TensorFlow cuando es necesario.
Recibirás código fuente limpio, un modelo entrenado, resultados de evaluación, visualizaciones y documentación clara. Los paquetes Estándar y Premium incluyen una afinación más profunda y comparación de modelos, mientras que el Premium también puede incluir integración con Flask API.
Por favor, envíame un mensaje con tu conjunto de datos y objetivo del proyecto antes de ordenar para poder recomendarte el paquete adecuado.
Gracias,
Kawsar Ahmmed




Lenguaje de programación:
Python
•
SQL
•
Colab
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Otros
Herramientas:
Jupyter Notebook
•
TensorFlow
•
Excel
•
Colab
Traducción automática
¿Con qué tipos de conjuntos de datos puedes trabajar?
Principalmente trabajo con conjuntos de datos estructurados o tabulares como archivos CSV y Excel que contienen características numéricas o categóricas. Si no estás seguro de si tu conjunto de datos es adecuado, por favor envíame un mensaje antes de ordenar.
¿Necesito saber si mi problema es de clasificación o regresión?
No. Solo explica qué quieres predecir y revisaré tu variable objetivo y te recomendaré el enfoque de machine learning más adecuado.
¿Cómo eliges el modelo de machine learning correcto para mis datos?
Comparo algoritmos adecuados según tu conjunto de datos, tipo de problema y métricas de evaluación. Dependiendo del proyecto, puedo usar modelos como regresión logística o lineal, random forest, XGBoost, LightGBM, CatBoost, SVM o KNN.
¿Qué recibiré con mi pedido?
Dependiendo del paquete, recibirás código fuente limpio en Python, un Jupyter Notebook, flujo de trabajo de preprocesamiento, modelo entrenado, resultados de evaluación, visualizaciones relevantes y documentación del modelo.
¿Puedes trabajar con conjuntos de datos desordenados o desequilibrados?
Sí. Puedo manejar problemas comunes como valores faltantes, características categóricas, escalado, ingeniería de características y desequilibrio de clases usando técnicas de preprocesamiento apropiadas.
¿Puedes garantizar una precisión o puntuación de rendimiento específica?
No se puede garantizar una precisión fija porque el rendimiento del modelo depende de la calidad, tamaño, equilibrio y la información predictiva en el conjunto de datos. Utilizaré validación, métricas y métodos de optimización adecuados para lograr un resultado confiable.
¿Proporcionas integración API para el modelo entrenado?
Sí. El paquete Premium puede incluir integración con Flask API para que el modelo entrenado pueda aceptar entradas y devolver predicciones a través de una API. La implementación en la nube no está incluida a menos que se acuerde por separado.