Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de datos
¿Tienes consultas lentas en BigQuery, modelos dbt rotos o trabajos de Spark sin optimizar?
Soy un ingeniero de datos senior (certificado asociado de Databricks) con más de 5 años de experiencia en construir y optimizar arquitecturas de datos escalables en la nube (GCP, Databricks, BigQuery). Me especializo en convertir pipelines de datos complejos, lentos y costosos en flujos de trabajo rápidos, eficientes y rentables.
Lo que puedo hacer por ti:
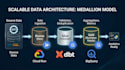
- dbt y almacenamiento de datos: construir y refactorizar modelos dbt siguiendo la arquitectura Medallion (Bronze, Silver, Gold), optimizar consultas SQL y configurar ejecuciones en Cloud Run / Control-M / Airflow.
- PySpark y Databricks: depurar, refactorizar y acelerar pipelines ETL por lotes con Spark (Scala/Python).
- Arquitectura en la nube de GCP: configurar pipelines escalables con BigQuery, Cloud Run y Airflow/Composer.
- Optimización de bases de datos y consultas: reducir costos de procesamiento y tiempos de ejecución en BigQuery/Snowflake.
¿Por qué trabajar conmigo?
- Experiencia certificada: ingeniero de datos certificado de Databricks y certificado en Azure.
- Código de alta calidad: prácticas de ingeniería de datos limpias, modulares y fáciles de mantener.
- Comunicación clara y directa: disponible en inglés y español.
NOTA: Contáctame con tus requisitos antes de hacer un pedido.

Traducción automática
¿Aceptas pedidos personalizados y a largo plazo?
Sí, pero solo para micro-tareas específicas o consultoría a tiempo parcial. Envíame un mensaje primero para discutir detalles.
¿Qué necesito proporcionar antes de comenzar?
Acceso al entorno en la nube (o datos/código de muestra anónimos) y una descripción clara del resultado esperado o registros de errores.
¿Podemos programar una llamada para discutir el proyecto?
Sí, a través de la función de videollamada de Fiverr una vez que se inicie un pedido o solicitud.


