Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
¿Ya probaste un scraper y te bloquearon? Esa es la tarea que tomo.
La mayoría de los vendedores pueden manejar una página estática simple. Trabajo en sitios que luchan activamente contra límites de tasa, tokens rotativos, solicitudes API firmadas, autenticación basada en sesiones y páginas con mucho JS que solo se renderizan después de iniciar sesión.
Lo que manejo:
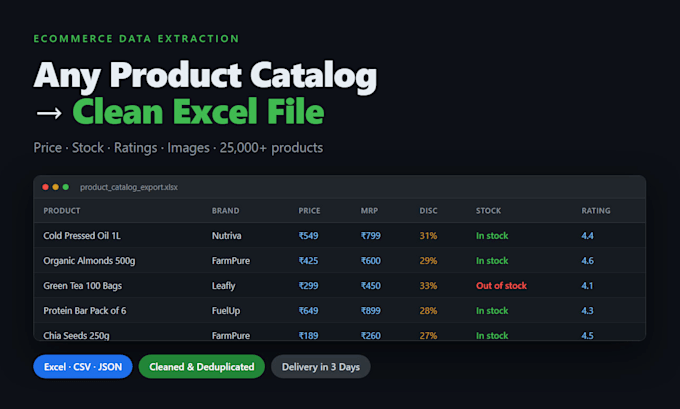
Lo que obtienes: CSV / Excel / JSON limpios, el script funcional y una nota breve sobre cómo volver a ejecutarlo.
He creado crawlers de producción contra plataformas principales de comercio electrónico y quick-commerce, incluyendo aquellas con protección WAF y esquemas de solicitudes firmadas. Si un sitio ha superado a tu desarrollador anterior, envíame la URL antes de ordenar y te diré honestamente si es factible.


Tecnología:
JavaScript
•
Python
•
scrapy
•
Selenium
•
Playwright
Técnica:
Automatizado