Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Copiar y pegar desde PDFs no escala, y el OCR genérico estropea las tablas. Los trabajos baratos de entrada de datos funcionan hasta que necesitas que sea repetible, auditable y que funcione cada semana sin que tengas que hacerlo tú.
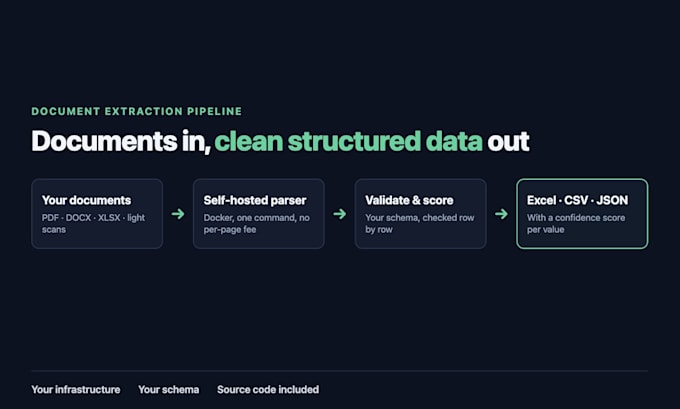
Yo construyo la pipeline en su lugar: documentos de entrada, datos estructurados limpios y listos para usar, en tu propia infraestructura.
LO QUE OBTIENES
- Una pipeline que tú mismo ejecutas (Docker, un comando)
- Tu esquema, tus campos, validados en cada fila
- Puntuación de confianza en cada valor extraído
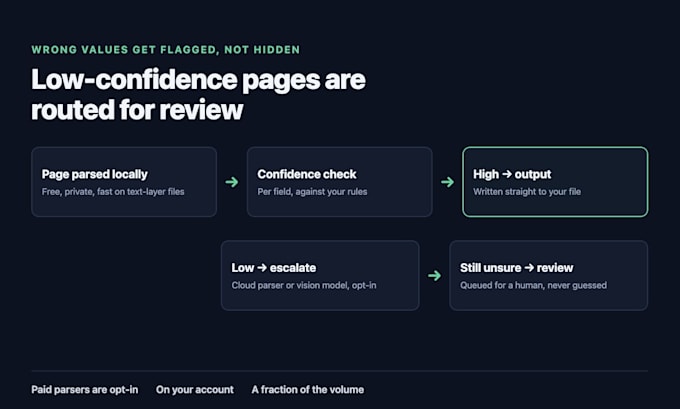
- Páginas con baja confianza enrutadas para revisión, no silenciosamente incorrectas
- Salida en Excel, CSV o JSON
- Código fuente y documentación de configuración
POR QUÉ AUTOALojARSE
El parser funciona localmente: sin tarifa por página, y tus documentos nunca salen de tu infraestructura. Los parsers en la nube de pago solo se usan para las páginas que realmente los necesitan, una fracción del volumen, en tu cuenta y a tu discreción.
CÓMO TRABAJO
Comienza con el Pilot. Envía 20-50 páginas reales. Yo las proceso y te envío un informe escrito: qué se extrajo con claridad, qué no, y qué campos necesitan reglas de revisión. Luego tú decides.
EN EL ÁMBITO
PDF de capa de texto, DOCX, XLSX, PPTX y escaneos ligeros. La escritura a mano, formularios y gráficos se cotizan por separado, solo pregunta.
Envía 3-5 páginas de muestra y los campos que necesitas.
Tecnología:
Excel
•
Python
Traducción automática
¿En qué se diferencia de un trabajo de entrada de datos de 20$?
Un trabajo de entrada de datos procesa tus documentos una sola vez. Esto es una pipeline que tú posees y vuelves a usar para siempre, con reglas de validación y puntuaciones de confianza para que puedas ver en qué valores confiar. Es una compra completamente diferente.
¿Pago por página?
No al parser, funciona en tu propia máquina, así que el volumen de páginas es gratis. Solo las páginas que necesitan un parser en la nube o un modelo de visión cuestan algo, en tu propia cuenta, y tú decides si habilitarlo o no.
¿Qué precisión puedes prometer?
Nada antes de haber visto tus documentos, y sé escéptico con cualquiera que diga lo contrario. Los benchmarks publicados de parsers varían mucho y los resultados dependen de tus diseños específicos. El Pilot lo mide primero en tus páginas reales.
¿Mis documentos salen de mi infraestructura?
No por defecto. El parser es autoalojado. Los parsers en la nube son opcionales, por página, y solo para las páginas que la pipeline local marque como de baja confianza. Si necesitas cero llamadas externas, dilo y lo construiré así.
¿Puedes manejar documentos escaneados?
Escaneos ligeros, sí. Escaneos pesados, escritura a mano y formularios son posibles pero requieren una cotización aparte. Son realmente más difíciles, y prefiero valorarlos honestamente que subestimar el precio.
¿Qué pasa con los valores que obtiene mal?
Se marcan, no se ocultan. Cada valor tiene una puntuación de confianza, y las filas con baja confianza se envían para revisión en lugar de escribirse en silencio en tu hoja de cálculo.
¿Quién lo ejecuta después de la entrega?
Tú. Es un contenedor Docker más tu código, con documentación de configuración. Un comando para empezar.