Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Desarrollo web Full Stack, ingeniería de datos, automatización en Python
Nivel 1
Ha cumplido determinados criterios de rendimiento y muestra un gran potencial en la plataforma.
¿Protecciones anti-bot, páginas dinámicas con JavaScript o scrapers que se rompen están paralizando tus operaciones de datos?
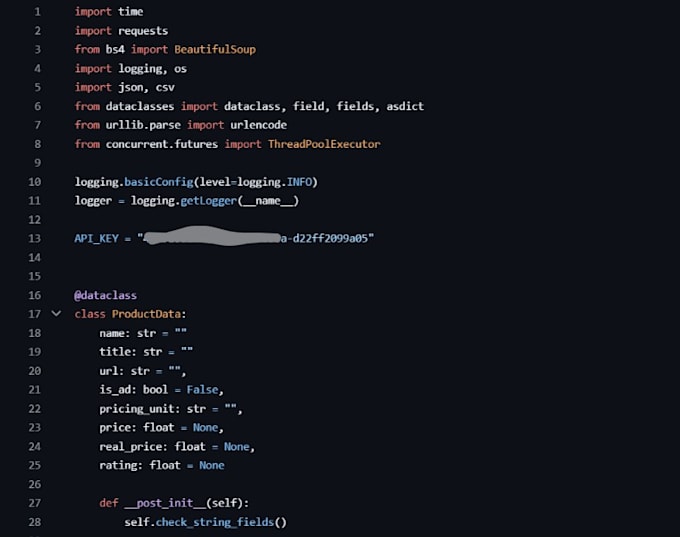
Construyo soluciones de web scraping en Python, resilientes y de grado de producción, usando Scrapy y Selenium para extraer datos limpios y estructurados a escala sin intervención manual.
Qué tengo preparado:
Pila tecnológica:


Tecnología:
Python
•
Excel
•
scrapy
•
Selenium
•
Beautiful Soup
Técnica:
Automatizado
Traducción automática
¿Puedes hacer scraping en sitios que requieren login o tienen JavaScript dinámico?
Sí. Uso Selenium y Playwright para manejar sesiones de inicio de sesión, cookies, flujos de autenticación de dos factores (donde sea factible) y contenido dinámico cargado por React/Vue o desplazamiento infinito.
¿Cómo evitas bloques de IP y límites de tasa?
Dependiendo del paquete y la arquitectura del sitio, implemento rotación aleatoria de user-agent, retrasos personalizados en las peticiones, backoff exponencial e integración con tu proveedor de proxy.
¿En qué formato recibiré los datos finales?
Puedes elegir CSV, XLSX (Excel), JSON o inserción directa en bases de datos SQL (PostgreSQL, MySQL, SQLite). Todos los conjuntos de datos se limpian, deduplican y validan con el esquema antes de entregarlos.