Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
El Bubble Freelance
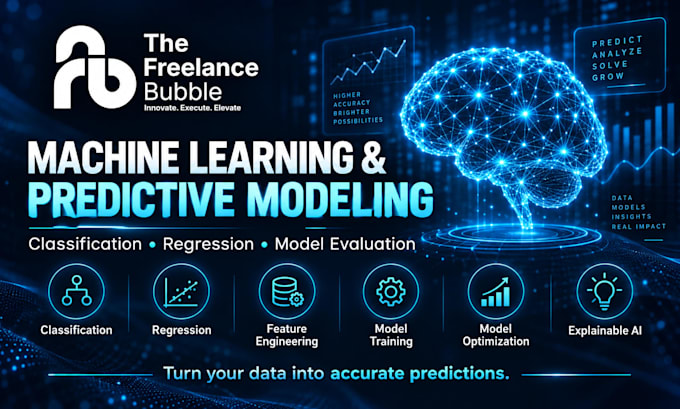
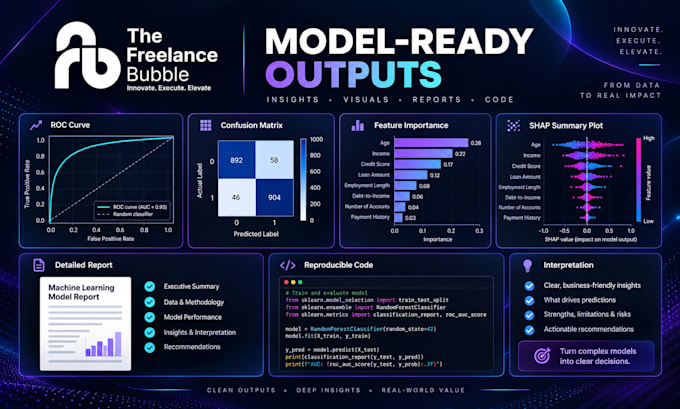
Construiré modelos de machine learning y predicción precisos, interpretables y con documentación profesional adaptados a tus datos y objetivos del proyecto.
Puedo trabajar con conjuntos de datos de investigación, salud, negocios, científicos y estructurados para transformar datos en bruto en predicciones significativas y conocimientos accionables.
Mis servicios incluyen:
Trabajo con Python, R, Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter, Colab y RStudio.
Por favor, contacta conmigo antes de ordenar para aprendizaje profundo, conjuntos de datos muy grandes, despliegue en la nube, integración de API o flujos de trabajo personalizados.
Traducción automática
¿Qué tipos de proyectos de machine learning puedes manejar?
Puedo trabajar en clasificación, regresión, clustering, detección de anomalías, análisis predictivo, ingeniería de características, modelos de árbol de decisión y evaluación de modelos para conjuntos de datos de investigación, salud, negocios y científicos.
¿Qué necesito proporcionar antes de comenzar?
Por favor, proporciona tu conjunto de datos, objetivo del proyecto, variable objetivo si aplica, resultado preferido y cualquier requisito o pregunta específica que quieras que el modelo aborde.
¿Qué lenguajes y herramientas de programación utilizas?
Principalmente uso Python y R con Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter Notebook, Colab, RStudio, SQL y otras herramientas de ciencia de datos relacionadas.
¿Proporcionarás el código fuente?
Sí. El código fuente o notebooks están incluidos según el paquete seleccionado y serán organizados para reproducibilidad y revisión.
¿Puedes comparar múltiples modelos de machine learning?
Sí. Los paquetes Estándar y Premium pueden incluir múltiples modelos, validación cruzada, comparación de modelos, optimización y selección basada en métricas de rendimiento apropiadas.
¿Proporcionas IA explicable o análisis SHAP?
Sí. La IA explicable, valores SHAP, importancia de características e interpretación pueden incluirse, especialmente en el paquete Premium o mediante una oferta personalizada.
¿Puedes trabajar con datos de salud o investigación?
Sí. Puedo analizar conjuntos de datos biomédicos, de salud, investigación y científicos. Asegúrate de que cualquier dato sensible esté debidamente anonimizado antes de compartirlo.
¿Ofreces despliegue de modelos o integración de API?
Sí, el despliegue en la nube y la integración de API pueden añadirse como extras o gestionarse mediante una oferta personalizada según la complejidad del proyecto.
¿Puedes garantizar una precisión específica del modelo?
No. El rendimiento del modelo depende de la calidad de los datos, tamaño de la muestra, equilibrio de clases, relevancia de las características y el problema de predicción subyacente. Me centro en validación rigurosa y reportes transparentes en lugar de garantías poco realistas.
¿Debo comunicarme con usted antes de realizar el pedido?
Sí, especialmente para conjuntos de datos grandes, aprendizaje profundo, proyectos de salud, despliegue, integración de API o requisitos personalizados de machine learning.