Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador de IA generativa RAG, LLMs, NLP, CV, soluciones de IA
¿Necesitas arquitectura de NLP y RAG de nivel producción? Deja de conformarte con simples envoltorios.
Hola, soy un ingeniero de IA especializado en procesamiento avanzado de lenguaje natural y sistemas de recuperación inteligentes. No solo conecto claves API básicas; diseño pipelines de LLM de nivel empresarial, de pila completa, optimizados para precisión y latencia.
Entregables operativos principales:
Vamos a dejar atrás los workflows legacy. Envía tus parámetros de datos.

Traducción automática
¿Qué formatos de datos puede procesar tu pipeline de RAG?
Diseño pipelines de ingesta de datos robustos capaces de procesar datos corporativos altamente no estructurados. Esto incluye corpus en PDF en bruto, matrices en CSV, arreglos en JSON y extracción directa de bases relacionales SQL o NoSQL. Si tus datos están siloed, construyo la capa de extracción para vectorizarlos.
¿Cómo evitas que el LLM alucine o invente hechos?
Implemento arquitecturas estrictas de Retrieval-Augmented Generation (RAG). El LLM está matemáticamente restringido a generar respuestas solo a partir de fragmentos semánticos recuperados de tu base de datos vectorial privada, garantizando cero alucinaciones.
¿Se usará mi data corporativa propietaria para entrenar modelos públicos?
Se aplica una gobernanza absoluta de datos. Las APIs empresariales garantizan que no se retengan datos para entrenamiento público. Para máxima seguridad, podemos desplegar modelos open-source completamente localmente en tus servidores aislados en AWS/Azure.
¿Solo usas prompt engineering o construyes infraestructura real?
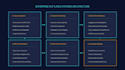
Soy arquitecto de sistemas, no un creador de prompts. Construyo infraestructura backend completa: desarrollo nodos en FastAPI, configuro bases de datos vectoriales NoSQL (Chroma/Pinecone), ejecuto lógica de fragmentación y vinculo bucles de recuperación de forma nativa.
¿Dónde despliego la aplicación final de IA?
El despliegue se ajusta a tu stack. Containerizo la pipeline usando Docker para integración CI/CD limpia, o despliego nodos de inferencia directamente en entornos cloud escalables como Amazon SageMaker o Azure ML Studio.
¿Recibo todo el código fuente y documentación técnica?
Sí. Recibes el código Python/FastAPI completo y sin encriptar, configuraciones de indexación de bases de datos y una definición completa de arquitectura técnica que detalla todos los protocolos de vectorización y enrutamiento API.


