Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
¿Estás buscando integrar datos personalizados en Large Language Models (LLMs) con alta precisión y baja latencia?
Construyo sistemas robustos y listos para producción de Retrieval-Augmented Generation (RAG) y flujos de trabajo de AI agentic adaptados a las necesidades de tu negocio.
Lo que ofrezco:
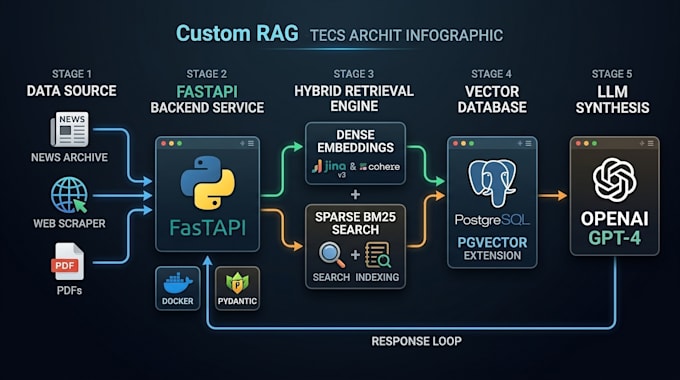
- Arquitectura RAG personalizada: segmentación de documentos, generación de embeddings (Cohere, OpenAI, Jina) y almacenamiento de vectores.
- Bases de datos vectoriales: integración con PostgreSQL (pgvector), Pinecone o Qdrant.
- Búsqueda híbrida: búsqueda densa + dispersa para máxima precisión en recuperación.
- Integración backend: APIs REST de alto rendimiento construidas con Python y FastAPI.
- Agentes de IA autónomos: flujos de trabajo LangGraph para tareas complejas y de múltiples pasos.
- Código limpio y documentación: código completamente tipado (Pydantic), documentado y en Docker.
Pila tecnológica:
Python | FastAPI | PostgreSQL / pgvector | LangChain / LangGraph | Docker | OpenAI / Cohere
Cómo trabajamos:
1. Contáctame con tus requisitos antes de hacer un pedido.
2. Definimos el alcance del proyecto, la pila tecnológica y los entregables.
3. Construyo, pruebo y entrego el sistema con instrucciones paso a paso.
Convierte tus datos en un sistema de IA inteligente. ¡Envíame un mensaje para comenzar!
Software Engineer
Idiomas
Traducción automática
Traducción automática
¿Puedes desplegar el sistema RAG en mi servidor?
Sí, proporciono configuraciones en Docker y guías de despliegue para plataformas en la nube como AWS, DigitalOcean o Hetzner.
¿Necesito mis propias claves API?
Sí, necesitarás tus propias claves API para servicios LLM (por ejemplo, OpenAI, Cohere, Anthropic). Puedo guiarte en cómo configurarlas.
