Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
Descripción del gig
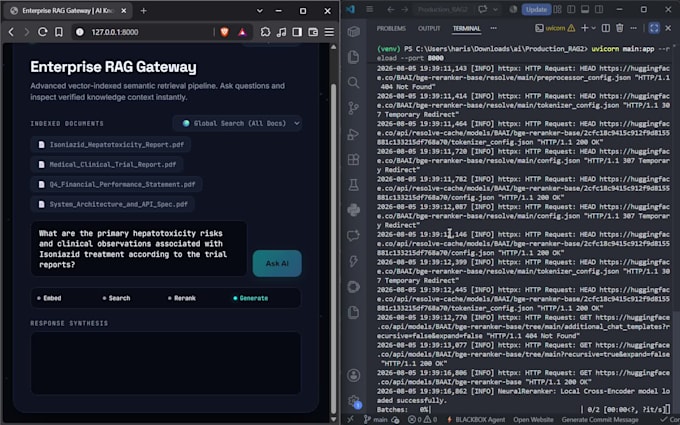
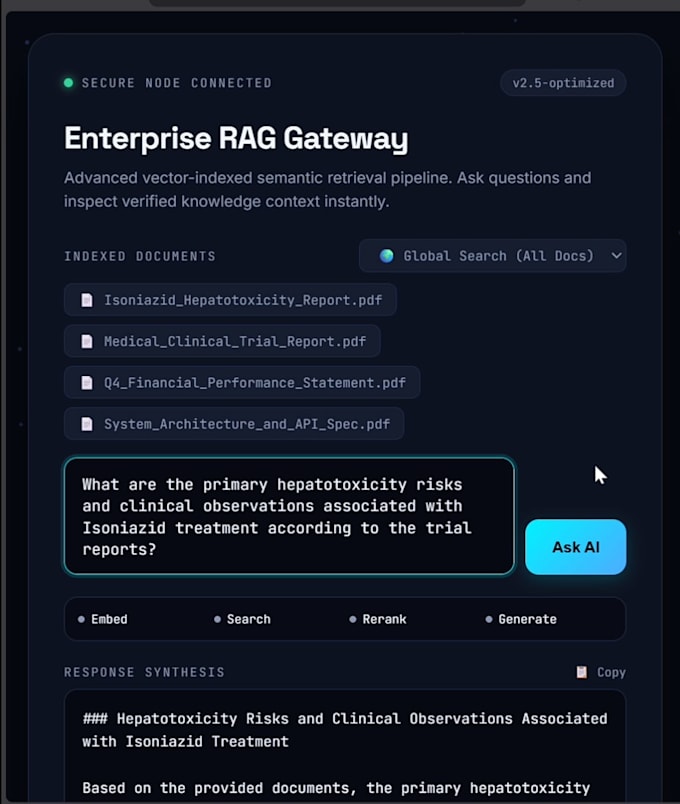
¿Quieres una IA que pueda chatear con tus PDFs, documentos o base de datos con precisión? Crearé un sistema RAG listo para producción para tu negocio...
Me especializo en arquitecturas de GenAI para producción y sistemas backend asíncronos usando Python, FastAPI, Vector DBs y LLMs (OpenAI, Groq, Llama 3).
️ Capacidades principales:
Pila tecnológica:
Python | FastAPI | Qdrant | Pinecone | LlamaIndex | LangChain | OpenAI | Groq | Docker
¿Por qué elegirme?
¡Hablemos de tu proyecto! Envíame un mensaje antes de hacer tu pedido para que podamos adaptar la arquitectura a tus necesidades específicas de datos.
Enterprise Rag and AI Systems Engineer
Idiomas
Traducción automática
Traducción automática
Q1: ¿Qué requisitos previos debo proporcionar antes de comenzar?
Respuesta: Necesitarás compartir las especificaciones de tu proyecto, datos/documentos de muestra y claves API para los proveedores de LLM o Vector DB elegidos (por ejemplo, OpenAI, Groq, Pinecone). Si no tienes las claves listas, puedo guiarte en configurarlas de forma segura en un archivo .env.
Q2: ¿Mis datos y claves API permanecerán seguros durante el desarrollo?
Respuesta: Sí, absolutamente. Tus datos, lógica de negocio y credenciales permanecen 100% confidenciales. Todas las credenciales sensibles se cargan mediante variables de entorno (.env) y nunca se codifican ni comparten.
Q3: ¿Puedes manejar análisis de documentos personalizados como tablas complejas y PDFs?
Respuesta: Sí. Utilizo herramientas de análisis conscientes del diseño (como LlamaParse) y estrategias de fragmentación personalizadas para extraer y estructurar tablas, PDFs, Markdown y documentos de texto antes de indexarlos en la base de datos vectorial.
Q4: ¿La aplicación está lista para despliegue en la nube?
Respuesta: Sí. Cada entregable incluye código Python estructurado, endpoints FastAPI, una plantilla .env.example y un Dockerfile optimizado para que puedas desplegar instantáneamente en AWS, GCP, Azure o cualquier servidor local.
Q5: ¿Qué pasa si un proveedor de LLM se cae o alcanza límites de tasa?
Respuesta: Construyo resiliencia incorporada usando algoritmos de reintento y enrutamiento de respaldo con múltiples proveedores (por ejemplo, cambiar automáticamente de Groq a OpenAI si se alcanzan límites de tasa) para garantizar alta disponibilidad.