Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
¿Necesitas un modelo de machine-learning que convierta tus datos en predicciones útiles?
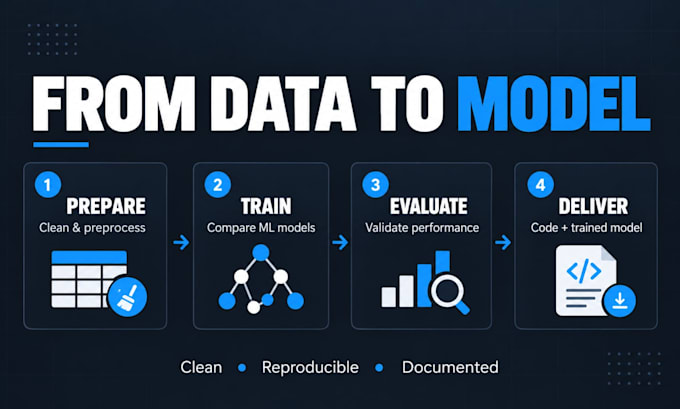
Construiré un modelo de clasificación o regresión personalizado usando tu conjunto de datos estructurado/tabular y proporcionaré una evaluación clara, código reproducible en Python y resultados documentados.
Puedo ayudarte con:
Por favor, contáctame antes de ordenar si tu conjunto de datos requiere limpieza extensa, múltiples fuentes de datos, deep learning, NLP, pronóstico de series temporales, despliegue en la nube o procesamiento a gran escala.
Los resultados dependen de tu conjunto de datos y configuración de evaluación, por lo que no puedo garantizar precisión específica ni resultados comerciales.


Lenguaje de programación:
Python
•
R
•
MATLAB
•
SQL
Marcos:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Otros
Herramientas:
Jupyter Notebook
•
opencv
•
OpenNN
•
TensorFlow
•
Excel
•
Colab
Traducción automática
¿En qué tipos de problemas de machine-learning puedes trabajar?
Este Gig se enfoca en problemas supervisados de machine-learning usando datos estructurados/tabulares, principalmente clasificación y regresión. Por favor, contáctame primero para pronósticos de series temporales, NLP, visión por computadora, deep learning o tipos de datos inusuales.
¿Qué es clasificación?
La clasificación predice una categoría o clase, como churn/no churn, fraude/no fraude, aprobado/rechazado, o una categoría entre varias posibles.
¿Qué es regresión?
La regresión predice un valor numérico, como un precio, nivel de demanda, puntuación, cantidad de ingresos u otro objetivo continuo.
¿Qué datos debo proporcionar?
Por favor, proporciona un conjunto de datos estructurado como CSV, Excel u otro formato tabular acordado, junto con una descripción de las columnas y el objetivo que deseas predecir.
¿Puedes limpiar mi conjunto de datos?
La limpieza está incluida dentro de los límites del paquete. Limpieza extensa, fusionar muchas fuentes de datos, etiquetado manual o reconstruir conjuntos de datos severamente incompletos puede requerir una oferta personalizada.
¿Qué algoritmos de machine-learning usarás?
El algoritmo depende de tu conjunto de datos y la tarea de predicción. Enfoques adecuados pueden incluir modelos de regresión, árboles de decisión, Random Forest, gradient boosting, XGBoost y otros métodos clásicos de ML apropiados.
¿Puedes garantizar una precisión específica?
No. El rendimiento del modelo depende en gran medida de la calidad, cantidad, relevancia, equilibrio y predictibilidad de los datos suministrados. Utilizaré métodos de evaluación adecuados y reportaré claramente los resultados obtenidos.
¿Recibiré el código fuente?
Sí. Recibirás el código Python reproducible o notebook incluido en tu paquete, junto con artefactos del modelo relevantes y documentación.
¿Puedes implementar el modelo?
El paquete Premium incluye un prototipo de API de inferencia o script de predicción por lotes. El despliegue completo en la nube, monitoreo, infraestructura escalable y MLOps en curso son servicios separados.