Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr

Traducción automática
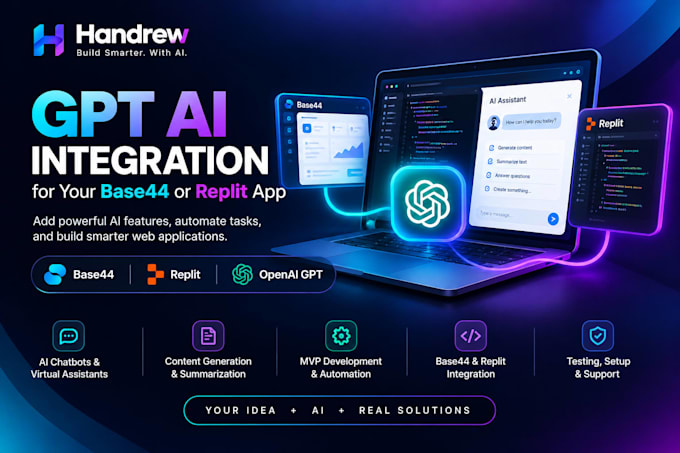
Integraré GPT en tu proyecto Base44 o Replit y entregaré un prototipo funcional (chat, automatización por webhook, memoria opcional) que convierta tu idea en una característica de IA demostrable y segura, lista para demostraciones o para llevar a producción.
Qué puedo construir
Qué obtendrás
¿Por qué trabajar conmigo?
PIDE AHORA
AI App Development , GPT Integration Specialist
Idiomas
Traducción automática
Traducción automática
¿Necesitas mi clave API de OpenAI?
Puedo usar tu clave o ayudarte a crear una; las claves permanecen en variables de entorno (p. ej., OPENAI_API_KEY) y nunca se comprometen ni se exponen en el cliente.
¿Puedes entregar el prototipo en 48 horas?
Sí — para proyectos de alcance reducido (una página de chat + un webhook) con acceso inmediato y requisitos claros.
¿Cómo aseguras los webhooks y las solicitudes?
Implemento verificación HMAC/secret-token, validación de payload, limitación de tasas y reintentos para una entrega confiable.
¿Cómo controlas los costos de OpenAI?
Uso límites de tokens, resumen de solicitudes, caché y registro básico de uso para que el gasto sea predecible y limitado.
¿La memoria de la conversación se almacenará y es privada?
La memoria de sesión a corto plazo se ofrece como opción; la memoria vectorial a largo plazo es un complemento — el almacenamiento y la retención siguen bajo tu control.
