Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
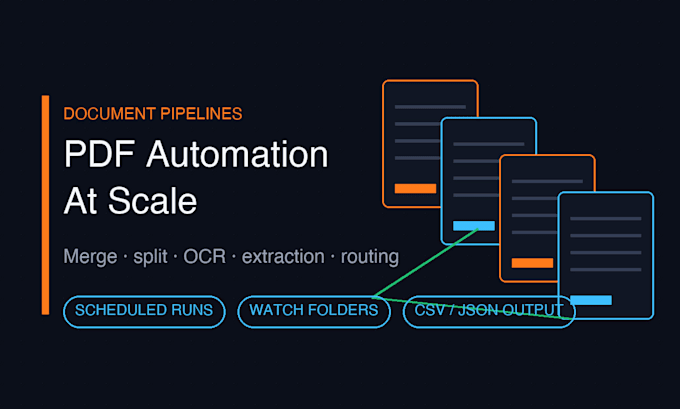
Deja de perder horas con tareas repetitivas de PDF. Construyo pipelines automatizados que procesan tus documentos de principio a fin: fusionar, dividir, reordenar, comprimir, OCR en páginas escaneadas, extraer tablas y campos a CSV/Excel, renombrar, ordenar y archivarlos donde corresponda.
Lo que entrego: fusión, división y manipulación de páginas a escala; OCR para hacer buscables facturas, contratos y formularios escaneados; extracción de datos: tablas, conceptos, fechas, IDs → CSV, Excel o Google Sheets; procesamiento por lotes para cientos o miles de documentos PDF; flujos desencadenados: correo electrónico, vigilancia de carpetas, webhook de API o cron; manejo de errores e informe de fallos en cada ejecución, sin pérdidas silenciosas.
Construido en Python con bibliotecas probadas en batalla, envuelto en n8n o en un script independiente que puedes ejecutar tú mismo. Funciona en tu máquina o en un servidor pequeño, tus datos nunca salen de tu control.
Ideal para oficinas contables, equipos legales, logística y cualquier área de operaciones ahogada por el papeleo.
Envíame un mensaje con un archivo de muestra y el resultado que quieres. Confirmo el alcance antes de que hagas el pedido.
Full Stack Developer, Mobile Flutter Kotlin Swift, Web Java Angular, Desktop
Idiomas
Traducción automática
Traducción automática
¿El pipeline puede ejecutarse en un horario programado?
Sí — entrego un script o un servicio que puedes activar manualmente, en un cron o vía API/webhook.
¿Qué volúmenes de archivos puedes manejar?
Desde un solo PDF hasta lotes de 10,000+. Los lotes grandes se procesan en bloques con seguimiento del progreso y un informe de fallos.
¿Trabajas con PDFs escaneados o basados en imágenes?
Sí. Agrego un paso de OCR (Tesseract) para que facturas, contratos o formularios escaneados sean buscables y extraíbles.