Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
¿Buscas una pipeline automatizada confiable y de alta velocidad para procesar secuencias biológicas FASTA sin trabajo manual?
Me especializo en construir pipelines modulares y reproducibles en Bash y Python, diseñadas para la extracción de secuencias FASTA de NCBI y análisis bioinformático posterior.
### Lo que ofrezco en este gig:
- Recuperación automatizada de secuencias NCBI: descarga en lote de secuencias FASTA usando IDs de acceso.
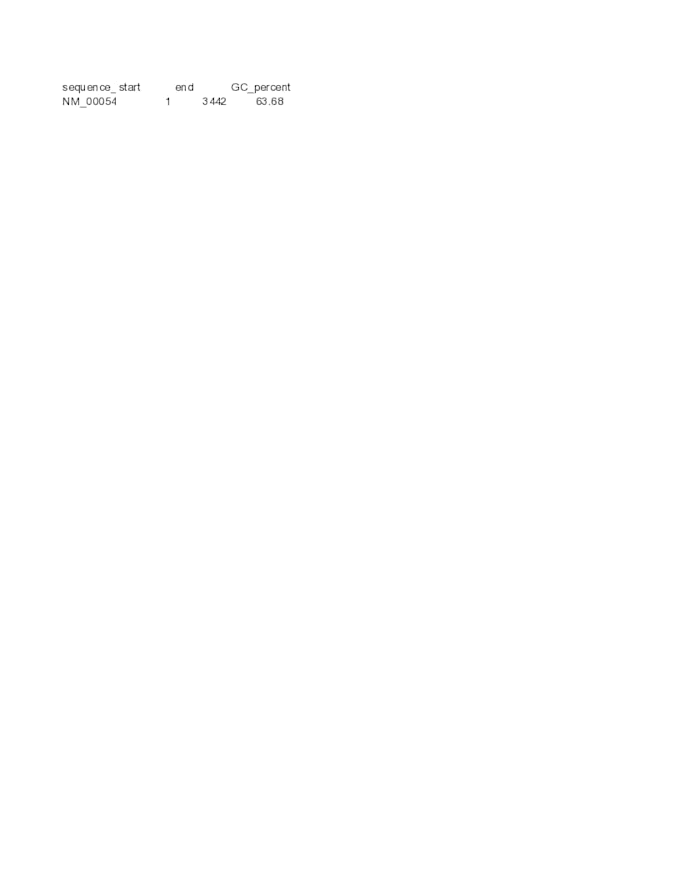
- Estadísticas y métricas de secuencias: calcular longitud total, porcentajes de contenido GC/AT y estadísticas N50.
- Perfil de GC en ventanas: análisis detallado del contenido GC en ventanas deslizantes.
- Manipulación de secuencias: generación automática de complementos inversos y limpieza de encabezados FASTA.
- Exportación de datos estructurados: informes limpios en TSV/CSV para análisis posterior.
### ¿Por qué elegir mi servicio?
- Código limpio y bien documentado: scripts modulares en Bash y Python diseñados para reutilización sencilla.
- Flujos de trabajo optimizados para almacenamiento: ejecución eficiente en línea de comandos en entornos Linux.
- Rápido tiempo de entrega y soporte completo: instrucciones detalladas para una ejecución sin problemas en tu terminal.
No dudes en enviarme un mensaje con los requisitos específicos de tu proyecto antes de hacer un pedido.