Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
Evaluaré, compararé y optimizaré tus prompts de AI o flujos de trabajo de LLM para mejorar la fiabilidad, coherencia y calidad de salida.
Revisaré tu prompt existente, lo probaré con ejemplos de entrada, identificaré debilidades o patrones de fallo y ofreceré mejoras optimizadas basadas en evaluación y benchmarking estructurados.
Dependiendo del paquete seleccionado, los servicios pueden incluir:
Mi proceso utiliza un marco de evaluación propietario diseñado para medir mejoras con resultados basados en evidencia en lugar de prueba y error en la edición de prompts.
Este servicio es adecuado para:
El objetivo es ayudar a que tus sistemas de IA funcionen de manera más fiable en entradas del mundo real y casos límite.
Nota, los casos de prueba están limitados a 5 para Basic, 20 para estándar y 50 para premium.
Data Driven AI Evaluation and Optimization
Idiomas
Traducción automática
Traducción automática
¿Qué tipos de problemas puedes ayudar a mejorar?
Ejemplos incluyen: Respuestas incoherentes Alucinaciones Seguimiento pobre de instrucciones Razonamiento débil Problemas de tono/estilo Formato JSON inválido Verborragia excesiva Problemas de fiabilidad en diferentes entradas
¿Proporciona informes?
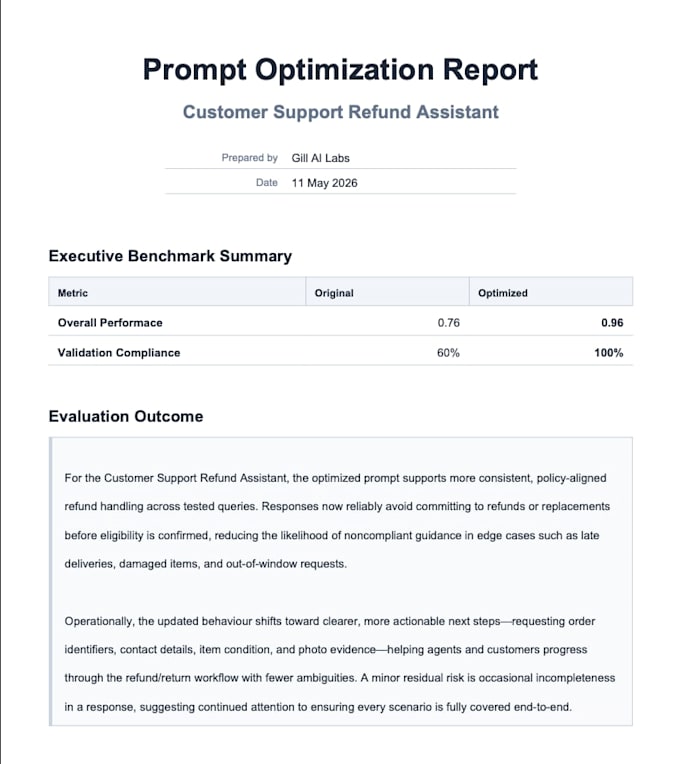
Sí. Dependiendo del paquete seleccionado, los informes pueden incluir: Resultados del benchmarking Comparaciones antes y después Recomendaciones de optimización Resúmenes de evaluación Análisis de fiabilidad
¿Puedes probar prompts con conjuntos de datos o múltiples escenarios?
Sí. Los paquetes de nivel superior pueden incluir pruebas estructuradas de benchmark en múltiples casos de prueba y casos límite.
¿Garantizas resultados perfectos con AI?
Ningún sistema de IA puede garantizar un rendimiento perfecto en todas las situaciones. El objetivo es mejorar significativamente la fiabilidad, coherencia y calidad general de salida mediante métodos estructurados de evaluación y optimización.
¿Qué modelos de IA soportan?
Puedo trabajar con prompts y flujos de trabajo para: ChatGPT de OpenAI Claude de Anthropic Google Gemini
¿Qué necesitas de mí?
Por favor, proporciona: Tu prompt o flujo de trabajo actual El objetivo del sistema de IA Ejemplos de entradas y salidas (si están disponibles) Cualquier requisito de formato, tono o negocio Detalles de cualquier problema que estés experimentando