Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
¿Buscas ajustar modelos LLM de código abierto como LLaMA 3, Mistral o Qwen a tus datos privados de negocio?
Me especializo en ajuste fino eficiente en parámetros (PEFT) usando LoRA de vanguardia y QLoRA de 4 bits con Hugging Face TRL y PyTorch. ¡Entrena modelos masivos en GPUs de consumo o en la nube sin perder precisión!
Lo que ofrezco:
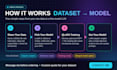
Preparación de conjuntos de datos personalizados: limpia, tokeniza y da formato a los datos crudos en prompts de instrucción en formato JSONL.
Ajuste de 4 bits con QLoRA y LoRA: cuantización NF4 y optimizadores paginados para un entrenamiento eficiente en memoria.
Soporte para múltiples modelos: Meta LLaMA 3 / 3.2, Mistral 7B, Qwen 2.5, DeepSeek y Gemma.
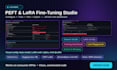
Interfaz Web interactiva: un tablero personalizado en Streamlit para inspeccionar datos, ver curvas de pérdida y probar prompts.
Fusión y despliegue: fusionar adaptadores LoRA en pesos independientes listos para Ollama, vLLM o HF Hub.
Listo para producción: guiones de inferencia completos, documentación y manejo de errores.
️ Stack tecnológico:
PyTorch | Hugging Face TRL | PEFT LoRA | bitsandbytes | Streamlit | vLLM | Ollama
Por favor envíame un mensaje antes de hacer el pedido para que podamos discutir la mejor arquitectura de modelo para tus datos.
AI Automation and Custom Workflow Engineer Multi Agent
Idiomas
Traducción automática


