Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr



Traducción automática
¿Necesitas un scraper web rápido y fiable o un pipeline de extracción de datos automatizado? ¡Estás en el lugar correcto!
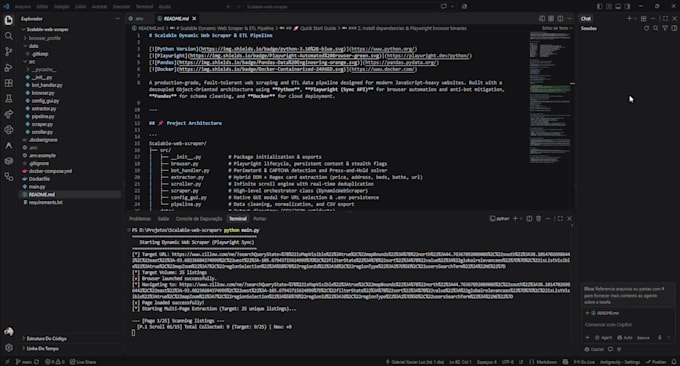
Construyo scrapers de producción en Python usando Playwright, Pandas y Docker. A diferencia de scripts básicos que fallan en sitios web modernos, mis soluciones manejan JavaScript dinámico complejo, feeds de desplazamiento infinito y defensas anti-bot.
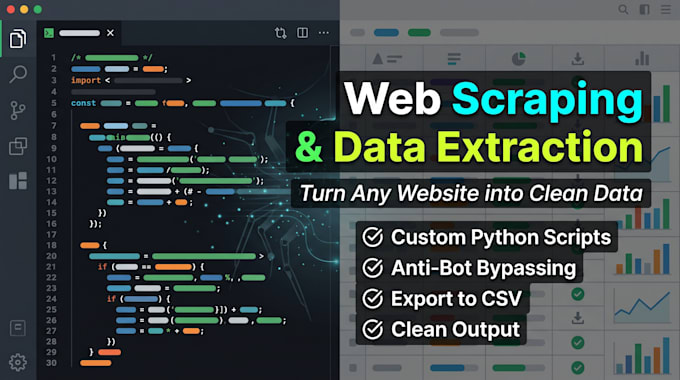
Lo que entrego: Scraping dinámico de JS: aplicaciones de una sola página, desplazamiento infinito y elementos cargados perezosamente. Mitigación anti-bot y CAPTCHA: evita PerimeterX, Cloudflare y overlays de desafío mediante cookies persistentes y mecánicas de navegador humanizadas. Limpieza de datos automatizada (Pandas): normaliza texto en números limpios, separa direcciones y elimina duplicados. Navegación multi-página: paginación automática para extraer conjuntos de datos de alto volumen. Formatos limpios: CSV compatible con Excel, JSON o Google Sheets. Listo para Docker: despliegue en contenedor con un clic para PCs locales o servidores en la nube (AWS/GCP).
Casos de uso: listados de bienes raíces, precios de comercio electrónico, directorios B2B.
️¡Envíame un mensaje con tu URL objetivo y requisitos antes de hacer un pedido!
Python Developer, Automation and Data Processing
Idiomas
Traducción automática
Traducción automática
¿Por qué debo enviarle un mensaje antes de realizar un pedido?
Cada sitio web tiene una estructura única, comportamiento de JavaScript dinámico y seguridad anti-bot. Revisar la URL del sitio objetivo de antemano me permite verificar la viabilidad, revisar los campos de datos requeridos y ofrecerte el paquete más rentable.
¿Puedes scrapear sitios web con CAPTCHAs, Cloudflare o PerimeterX?
¡Sí! Utilizo Playwright con sesiones de navegador persistentes, mecánicas de ratón humanizadas y configuraciones de banderas de sigilo diseñadas específicamente para sortear overlays de verificación de bots modernos y desafíos dinámicos.
¿En qué formatos recibiré los datos extraídos?
Ofrezco datos limpios y formateados en CSV listo para Excel (codificación adecuada para evitar errores de formato), XLSX, JSON o sincronización directa a Google Sheets. También recibes el código fuente completo en Python y la documentación.
¿Qué necesito para ejecutar este scraper en mi propia computadora?
Tienes dos opciones sencillas: ejecutarlo localmente con Python estándar, o usar la configuración de Docker incluida (docker compose up) para correr todo el scraper en un solo comando sin instalación previa ni dependencias.
¿Puede este scraper ejecutarse automáticamente en la nube según un cron schedule?
¡Sí! Con el Dockerfile incluido, el scraper está 100% listo para la nube y se puede desplegar en AWS, Google Cloud Run o DigitalOcean para ejecutarse automáticamente en trabajos cron programados (p. ej., diario o semanal).