Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Precios para nuevos vendedores: los primeros 5 pedidos tienen descuento mientras construyo mi historial de reseñas.
Un modelo que puedes defender, no solo una puntuación en la que tienes que confiar.
Lo que obtienes
- Validación honesta: división estratificada o basada en tiempo, reportada tal cual
- Feature engineering basado en tu negocio: RFM, comportamiento, transaccional, basado en tiempo
- Modelos comparados en la misma división, para que la elección esté justificada en lugar de suponerla
- Balance de clases manejado correctamente: SMOTE, pesos de clase o ajuste de umbral
- Importancia de las features clasificada y traducida a términos de negocio
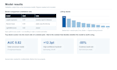
- Un resumen que un stakeholder no técnico pueda entender: AUC, lift, precisión en K
Herramientas: Python (Pandas, scikit-learn, NumPy, LightGBM), SQL
Historial: modelos de churn y recall con AUC 0.80, predicción de conversión de pedidos con 47 features en AUC 0.82, y un modelo de scoring de leads que aumentó la tasa de entrega con alta confianza del 7.7% al 20%.
Lo que necesito: una columna objetivo, unas miles de filas de historial y la decisión que la puntuación impulsará. Si tus datos aún están desordenados, puedo limpiarlos en el nivel Premium, o primero ordena mi Gig de limpieza de datos.
Envíame un mensaje con tu cantidad de filas y columna objetivo, y confirmaré el alcance antes de que hagas el pedido.
Lenguaje de programación:
Python
•
SQL
Marcos:
Scikit-learn
•
Panda
Herramientas:
Jupyter Notebook
•
Excel
Traducción automática
¿Qué algoritmo usarás?
Por problema, no por costumbre: modelos lineales regularizados como base, ensamblajes de árboles (LightGBM, scikit-learn), SVM o k-NN para datos pequeños no lineales, clustering para segmentos, ranking para listas ordenadas. Elegido en validación, nunca por moda, y te digo qué rechacé.
¿Qué precisión puedo esperar?
No prometo un número antes de ver los datos, y cualquiera que lo haga está adivinando. Lo que me comprometo a hacer es validación honesta y un informe claro de dónde falla el modelo. Como referencia, mis propios proyectos lograron AUC de 0.80 a 0.82 en problemas de churn y conversión.
Mi conjunto de datos es pequeño o está desequilibrado. ¿Aún puedes trabajar con él?
Generalmente sí. El desequilibrio se maneja con SMOTE, pesos de clase o ajuste de umbral en lugar de ignorarlo. Los datos pequeños son una limitación real — si hay muy pocos casos positivos te lo diré claramente antes de que hagas el pedido, en lugar de entregar un modelo en el que no se puede confiar.
¿Recibiré el código?
Sí en todos los paquetes. Recibirás un notebook o script que puedes volver a ejecutar, además de la lista final de features. El nivel Premium añade un script de producción, documentación escrita y una llamada de entrega.
¿Puedes desplegar el modelo en producción por mí?
No hago despliegue en la nube ni integración con API, y prefiero decirlo desde el principio en lugar de aceptar el pedido y decepcionarte. Lo que obtienes es un modelo y un script listos para que tu equipo de ingeniería los implemente.
Mis datos son sensibles. ¿Cómo los manejas?
Envía un extracto enmascarado o una pequeña muestra si prefieres. Solo pido las columnas que el modelo realmente necesita, no comparto tus archivos con nadie y elimino la copia de trabajo una vez que el pedido está completo.


