Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero de Datos en IA, Pipelines RAG, PDF a Markdown, LLMs Locales
Protege los datos confidenciales de tu empresa con una IA totalmente privada y ajustada localmente.
Enviar documentos sensibles, material instructivo o conocimientos internos a APIs en la nube pública representa un gran riesgo de seguridad y suele violar las regulaciones de GDPR.
Construyo modelos de IA seguros, offline, adaptados a tu sector específico. Aprovechando la arquitectura de Apple Silicon de alta gama (128 GB de memoria unificada) y frameworks avanzados como MLX y Unsloth, tus datos nunca salen de mi hardware aislado y local durante el proceso de entrenamiento.
Lo que entrego:
Mi stack tecnológico y experiencia:
Por favor, envíame un mensaje antes de hacer tu pedido.


Lenguaje de programación:
Python
Marcos y herramientas de modelos de IA:
Tipo de datos:
Texto
Motor de IA:
Otros
Traducción automática
¿Por qué debería ajustar finamente localmente en lugar de usar OpenAI u otras APIs en la nube?
Las APIs en la nube representan un gran riesgo de seguridad para los datos confidenciales de tu empresa y frecuentemente violan las políticas estrictas de GDPR. El ajuste fino local garantiza que tus documentos sensibles, datos de clientes y conocimientos internos nunca salgan de un entorno aislado y offline. Mantienes la soberanía total de tus datos.
¿Puedes ajustar modelos más grandes en hardware local?
Sí. Aprovecho una arquitectura de Apple Silicon de alta gama con 128 GB de memoria unificada. Combinado con frameworks avanzados de cuantización como MLX y Unsloth (QLoRA), esta enorme capacidad de memoria me permite ajustar y ejecutar modelos open-source grandes (como Llama, Mistral o Qwen) de manera eficiente y completamente offline.
¿En qué formato debe estar mi dato de entrenamiento?
Para el paquete Estándar, tus datos deben estar preparados en un archivo JSONL limpio que contenga pares estructurados de instrucciones y respuestas. Si tu conocimiento está actualmente en PDFs desordenados, texto sin formatear o documentos internos, mi paquete Premium incluye preprocesamiento personalizado en Python para extraer, limpiar y formatear los datos.
¿Qué archivos exactos recibiré al entregar?
Recibirás los pesos del adaptador LoRA ajustado junto con un archivo de modelo completamente fusionado y cuantizado (formato GGUF). Este archivo GGUF está listo para despliegue y puede ser arrastrado y soltado instantáneamente en motores de inferencia local como Ollama, LM Studio o AnythingLLM en tu hardware propio.
¿Cómo aseguras que el modelo realmente aprenda mi dominio y no solo sobreentrene?
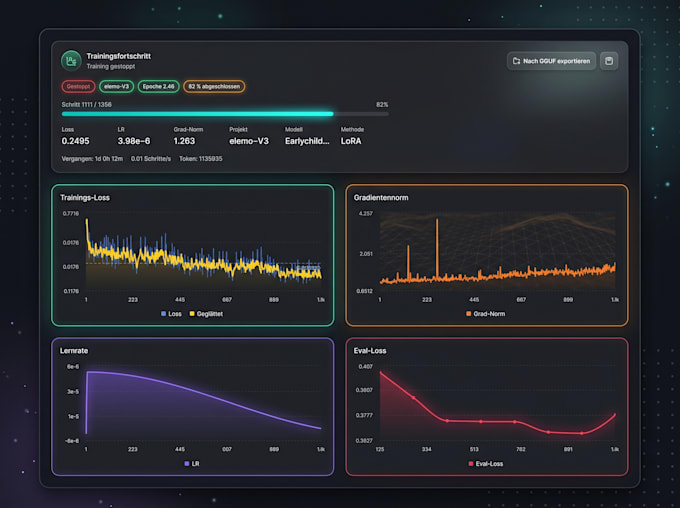
Monitoreo rigurosamente las curvas de pérdida durante el entrenamiento y ajusto los hiperparámetros para asegurar que el modelo generalice bien a tu terminología específica.