Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
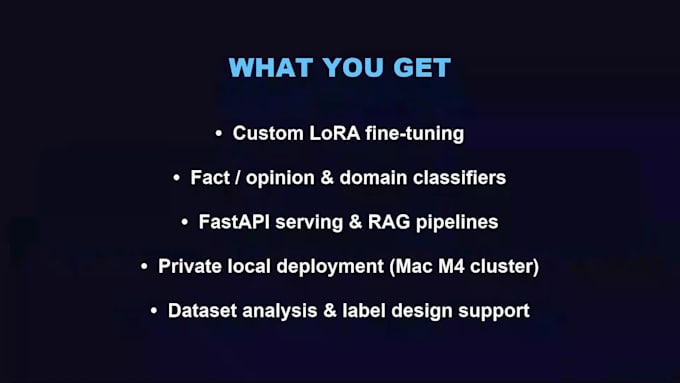
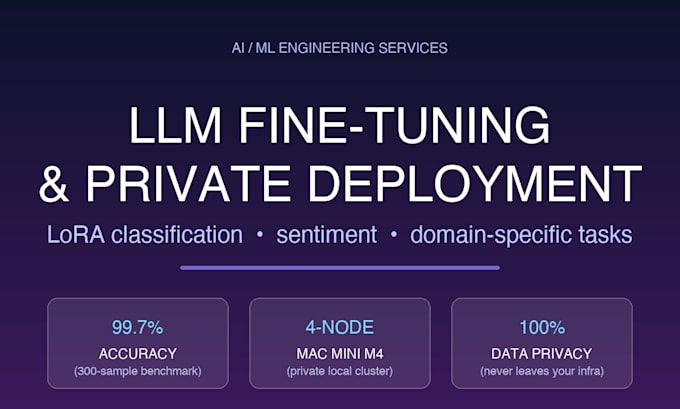
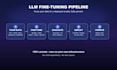
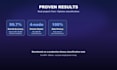
Personalización de LLM con ajuste fino usando LoRA/QLoRA para clasificación, análisis de sentimientos, transferencia de estilo y tareas específicas de dominio. Creé un clasificador binario de hechos/opiniones con Qwen3-14B-4bit LoRA que alcanzó 99.7% de precisión, y despliego todo en mi clúster privado de 4 nodos Mac Mini M4; tus datos nunca salen de tu entorno.
Lo que ofrezco:
Por qué elegirme:
Antes de hacer tu pedido: envíame un mensaje con tu tarea, tamaño y formato del dataset, idioma objetivo y plazo, para que pueda confirmar la viabilidad y el tiempo de entrega.
AI ML Engineer, LLM Fine tuning and Private Deployment Specialist
Idiomas
Traducción automática
Traducción automática
¿Qué datos necesitas de mí?
Muestras etiquetadas o no en CSV/JSON, o una descripción de la tarea.
¿Mis datos permanecerán privados?
Sí, todo el trabajo se realiza en mi clúster privado local, los datos nunca salen de tu infraestructura.
¿Qué obtengo después de la entrega?
Pesos del modelo afinado, informe de evaluación y guía de despliegue/API si aplica.
¿Qué modelos ajustas finamente?
Modelos populares de código abierto como Qwen, Llama, Mistral y más, usando LoRA/QLoRA eficiente.
¿Cuánto tiempo tardará?
Las tareas típicas pequeñas a medianas se entregan en 3-7 días, dependiendo del volumen de datos y la carga del clúster.
¿Puedes manejar datos de texto en idiomas que no sean inglés?
Sí, puedo afinar modelos multilingües como Qwen, BLOOM o MiniLM multilingüe para tareas de clasificación y NLP en idiomas no ingleses. Comparte tu idioma y dominio y configuraré el modelo adecuado para ti.
¿Qué opciones de despliegue ofreces?
Implementación privada mediante FastAPI + Docker (o MLX/vLLM para mayor rendimiento en producción) en tus propias máquinas: Mac Mini, Linux o servidores Windows. También configuré un endpoint interno de API para tu equipo.
¿Qué precisión puedo esperar?
Depende de la calidad de los datos y la dificultad de la tarea. Como referencia, mi clasificador de hechos/opiniones con Qwen3-14B LoRA alcanzó un 99.7% de precisión. Siempre recibes un informe completo de evaluación con precisión, F1 y análisis de errores.
¿Por qué usar LoRA/QLoRA en lugar de ajuste fino completo?
LoRA/QLoRA actualiza solo una pequeña fracción de los parámetros, reduciendo el costo de entrenamiento y la memoria hasta en un 90%, manteniendo una calidad cercana al ajuste fino completo. Se entrena más rápido y produce artefactos más pequeños, lo que hace que la implementación privada en hardware modesto sea práctica.