Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
¿Quieres mejorar tu aplicación con búsquedas semánticas de alto rendimiento, embeddings vectoriales personalizados y coincidencia rápida de similitudes?
Me especializo en construir arquitecturas de bases de datos vectoriales de nivel productivo, pipelines de búsqueda semántica y algoritmos de similitud personalizados usando Python, FastAPI, Qdrant y PostgreSQL (pgvector).
Lo que ofrezco:
Integración de bases de datos vectoriales: Configuración y ajuste de Qdrant, PostgreSQL (pgvector), Chroma o FAISS.
Pipelines de embedding: Segmentación de texto, optimización de tokens, modelos locales (SentenceTransformers, E5, BGE) o en la nube (OpenAI).
Algoritmos de similitud personalizados: Cálculos de similitud coseno, distancia euclidiana y producto punto.
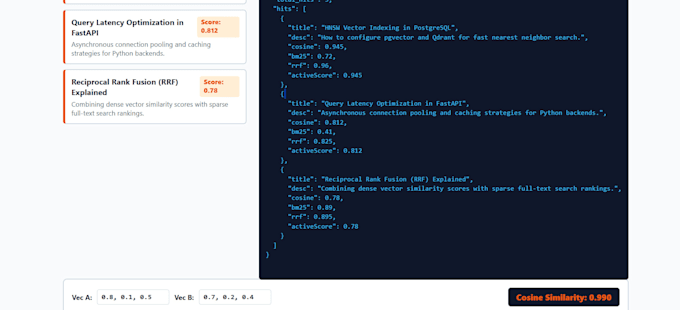
Búsqueda híbrida: Fusión de búsqueda de texto completo tradicional con recuperación de vectores densos usando Reciprocal Rank Fusion (RRF).
APIs de producción: Endpoints REST asíncronos diseñados con Python, FastAPI y validación con Pydantic.
Pila tecnológica:
Python, FastAPI, Qdrant, PostgreSQL (pgvector), SentenceTransformers, Hugging Face, PyTorch, Docker.
Por favor, envíame un mensaje antes de hacer un pedido para discutir tu conjunto de datos y requisitos.
AI Backend Engineer RAG Vector Search
Idiomas
Traducción automática
Traducción automática
¿Por qué usar búsqueda vectorial en lugar de coincidencia de palabras clave tradicional?
La búsqueda tradicional busca coincidencias exactas de palabras. La búsqueda vectorial analiza el significado semántico, encontrando contexto relevante incluso cuando los usuarios usan sinónimos o frases diferentes.
¿Esto puede funcionar 100% localmente para garantizar la privacidad total de los datos?
Sí. Puedo configurar modelos de embedding locales (como E5 o BGE mediante SentenceTransformers) y almacenes vectoriales locales (Qdrant o pgvector) para que los datos no salgan de tu servidor.
¿Qué es la búsqueda híbrida y por qué es mejor?
La búsqueda híbrida combina la búsqueda de vectores densos (significado semántico) con la búsqueda de palabras clave dispersas (BM25 o texto completo en PostgreSQL) usando Reciprocal Rank Fusion (RRF) para máxima precisión.