Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
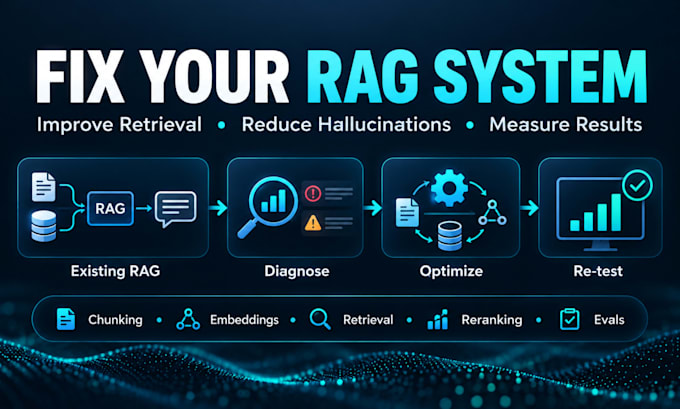
¿Tu sistema RAG está recuperando los documentos incorrectos, hallucina, produce citas poco confiables o responde demasiado lento?
Diagnosticaré y optimizaré tu pipeline RAG existente usando pruebas medibles de antes y después, no cambios aleatorios en los prompts.
Puedo ayudarte a mejorar:
- Estrategia de fragmentación
- Embeddings y búsqueda por vector
- Precisión en la recuperación
- Filtrado por metadatos
- Búsqueda híbrida
- Reranking
- Construcción de prompts y contexto
- Reducción de hallucination y grounding
- Calidad de citas
- Latencia y uso de tokens
- Rendimiento de la base de datos vectorial
- Evaluación RAG
Mi proceso:
Medir -> Diagnosticar -> Corregir -> Reprobar -> Comparar
Trabajo con sistemas RAG basados en Python, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, LLMs locales, Pinecone, Qdrant, Chroma, Weaviate, pgvector y stacks similares.
Recibes evidencia clara de:
- Qué causó el problema
- Qué se cambió
- Cómo funcionó el sistema antes y después
- Cualquier limitación restante
Este gig es para sistemas RAG existentes. Para sistemas de producción grandes, múltiples integraciones o reconstrucciones de arquitectura, por favor contáctame antes de ordenar.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Idiomas
Traducción automática
Traducción automática
1. ¿Construyes un sistema RAG desde cero?
Este Gig se enfoca en diagnosticar y mejorar un pipeline de RAG existente. El desarrollo de un sistema nuevo debe gestionarse como un proyecto personalizado.
2. ¿Puedes reducir las alucinaciones?
Sí. Investigo si las alucinaciones provienen de recuperación, fragmentación, construcción de contexto, prompts, citas o comportamiento del modelo y soluciono la causa real.
3. ¿Puedes mejorar la precisión en recuperación?
Sí. Puedo revisar la fragmentación, embeddings, búsqueda vectorial, filtros de metadatos, búsqueda híbrida, reordenamiento y configuraciones de recuperación.
4. ¿Puedes trabajar con Pinecone, Qdrant, Chroma, Weaviate o pgvector?
Sí, dependiendo de tu arquitectura actual y requisitos del proyecto.
5. ¿Puedes optimizar la latencia y el costo de API?
Sí. Se puede revisar y optimizar la latencia, uso de tokens, tamaño del contexto, llamadas innecesarias a LLM y eficiencia en recuperación.
6. ¿Puedes garantizar una mejora específica en la precisión?
No. Primero mido la línea base actual y luego informo la mejora real lograda en casos de prueba representativos.
¿Qué necesitas de mí para comenzar?
Por favor, comparte tu código fuente o repositorio, la arquitectura RAG actual, la base de datos vectorial, el modelo de embedding, algunos documentos de la base de conocimientos, preguntas de prueba representativas y algunos ejemplos de los fallos que quieres solucionar. Si tienes respuestas esperadas, registros o resultados de evaluación, también serán de ayuda