Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Experto en automatización de workflows, LLMs, bots, OCR
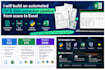
Deja de pagar por hora por teclear manualmente. Creo pipelines automatizados que extraen datos estructurados directamente de documentos escaneados, PDFs e imágenes, sin necesidad de reescritura manual.
Lo que hago:
Para quién es esto:
Tecnologías que uso: Python, Tesseract OCR, Pandas, OpenPyXL, PostgreSQL, DuckDB
Traducción automática
¿Con qué formatos de archivo puedes trabajar?
A: PDFs escaneados, imágenes JPG/PNG y archivos TIFF de varias páginas. Envía una muestra y confirmaré la precisión antes de que hagas el pedido.
¿Qué pasa si mis documentos tienen diseños desordenados o inconsistentes?
A: Creo un script de análisis personalizado según tu diseño específico. Envía 2-3 archivos de muestra con tu pedido para que pueda ajustarlo correctamente.
¿Puedes configurarlo para que mi equipo pueda ejecutarlo después por sí mismo?
A: Sí — Los paquetes Estándar y Premium incluyen el script y instrucciones básicas para que no dependas de mí para cada nuevo lote.
¿Garantizas una precisión del 100% en OCR?
A: La precisión del OCR depende de la calidad del escaneo. Incluyo un paso de validación/limpieza para detectar y marcar errores probables, pero escaneos de muy baja calidad pueden requerir revisión manual.


