Explorar las categorías
Explora
Fiverr Pro
Español
$
USD


Traducción automática
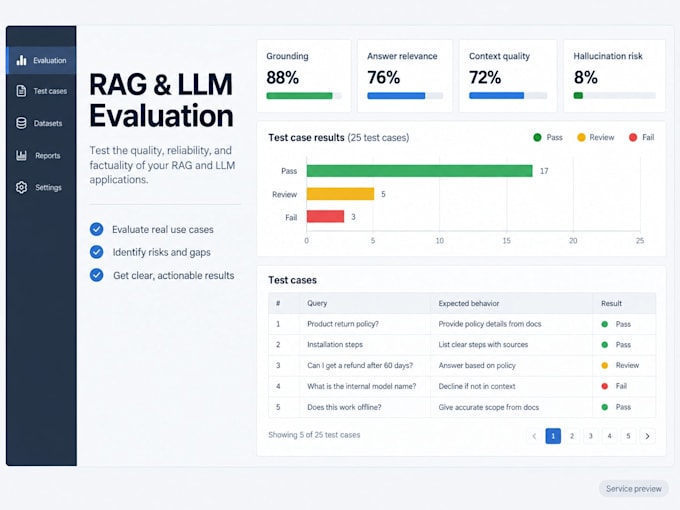
¿Tu aplicación RAG o LLM está generando respuestas no soportadas, irrelevantes o inconsistentes? Evaluaré su comportamiento y ofreceré recomendaciones basadas en evidencia para mejorarla.
Puedo valorar:
Relevancia, claridad y completitud de las respuestas
Fundamentación en el contexto recuperado
Alucinaciones y afirmaciones no respaldadas
Calidad de recuperación y utilidad de las fuentes
Consistencia en las citas
Patrones de fallo y comportamiento de fallback
Indicadores de latencia y costo cuando los datos están disponibles
Decisiones sobre fragmentación, contexto y configuración del modelo
Dependiendo del paquete, revisaré los casos de prueba proporcionados, crearé un conjunto estructurado de evaluación, analizaré fallos en recuperación y generación, y usaré métricas automatizadas cuando sean técnicamente apropiadas. Recibirás un informe claro que separa observaciones, evidencias, limitaciones y recomendaciones priorizadas.
Por favor, proporciona acceso a un entorno de prueba seguro o resultados exportados de la aplicación, contextos recuperados, respuestas esperadas cuando estén disponibles y una descripción de los usuarios y el caso de uso previsto. Elimina claves API, credenciales de producción y datos privados de clientes.
Este Gig evalúa un sistema existente. Implementar cambios importantes, reconstruir la pipeline RAG, desplegar en producción y
Python Backend Applied AI Developer
Idiomas
Traducción automática
Traducción automática
Q: ¿Qué cuenta como un caso de evaluación?
A: Un caso incluye una pregunta del usuario, la respuesta generada y el contexto o fuentes recuperadas utilizadas para producirla. Las respuestas esperadas o de referencia son útiles pero no siempre necesarias.
Q: ¿Necesitas acceso a mi sistema de producción?
A: No. Prefiero un entorno de prueba seguro, resultados exportados o una versión local reproducible. Por favor, elimina claves API, credenciales de producción, información personal y datos confidenciales de clientes antes de compartir cualquier cosa.
Q: ¿Qué métricas de evaluación usas?
A: Las métricas dependen de la aplicación y los datos disponibles. La evaluación puede cubrir relevancia de respuestas, relevancia del contexto, fidelidad, fundamentación en fuentes, calidad de recuperación, patrones de alucinación, latencia y costos. Las herramientas automatizadas pueden incluir RAGAS o métodos equivalentes cuando sean apropiados.
Q: ¿Implementarás las mejoras recomendadas?
A: Este Gig se centra en la evaluación y recomendaciones. Se pueden ofrecer ajustes pequeños acordados por separado, mientras que cambios importantes en la pipeline, nuevas funciones y despliegue requieren una oferta personalizada.
Q: ¿Puedes garantizar que la evaluación eliminará las alucinaciones?
A: Ningún evaluador responsable puede garantizar que un LLM nunca alucinará. Identificaré patrones de fallo observados, los mediré cuando sea posible y recomendaré formas prácticas de reducir su frecuencia e impacto.