Haré pipelines de datos escalables usando pyspark, databricks y azure

Parte de la información se ha traducido automáticamente.

India

Hablo Hindi, Inglés

Ingeniero de datos sénior

Soy Ingeniero de datos sénior con más de 6 años de experiencia diseñando y optimizando pipelines de datos escalables en Azure y AWS. Me especializo en PySpark, Databricks y soluciones ETL/ELT en la nu...
Acerca de este Servicio

¿Luchas con consultas SQL lentas, silos de datos desordenados o altos costos en la nube? Soy un Ingeniero de datos empresarial (certificado en Microsoft Azure) especializado en PySpark, Azure Databricks, Delta Lake y SQL. Diseño, optimizo y construyo arquitecturas de datos a prueba de fallos que convierten datos brutos en pipelines listos para analítica e IA.

Qué puedo hacer por ti:

  • Diseño de pipelines ETL / ELT: pipelines escalables por lotes y streaming usando PySpark, Databricks y Azure Data Factory (ADF).
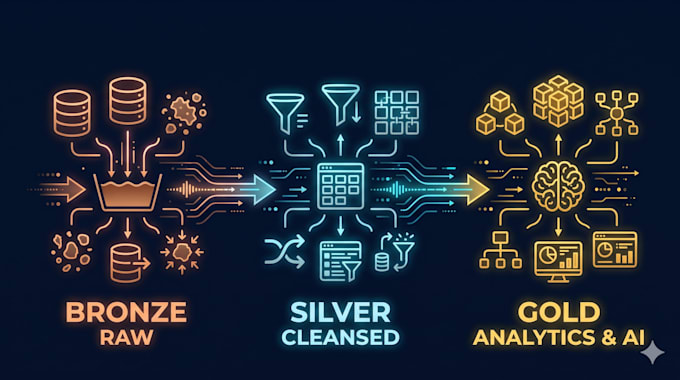
  • Arquitectura Medallion Lakehouse: Estructuro datos en capas Delta Lake Bronce, Plata y Oro en ADLS Gen2.
  • Optimización de rendimiento y costos: Arreglo de trabajos Spark lentos, solución de sesgo de datos, sintonización de consultas Oracle/PostgreSQL e implementación de Z-Ordering/ Liquid Clustering.
  • Preparación de datos para IA y RAG: Conecto data lakes empresariales a bases de datos vectoriales (pgvector) y Kubernetes (AKS) para recuperación en tiempo real de IA.

¿Por qué trabajar conmigo?

  • Código modular y de grado de producción con diagramas arquitectónicos claros.
  • Gran experiencia en Azure, Databricks, Python y bases de datos relacionales.
  • Comunicación clara y recorrido post-entrega.

Envíame un mensaje antes de pedir para alinear tu pila de datos y alcance del proyecto.

Idioma:

Inglés

•

Hindi

Experiencia técnica:

Databricks

•

Snowflake

•

Google BigQuery

Experiencia:

Canalización de datos

•

Desarrollo ETL

industria:

Audio y video

•

Análisis de Datos

•

Servicios financieros