Explorar las categorías
Español
$
USD
Conéctate con tu IA

Traducción automática
Tu característica de LLM pasó la demo. ¿Seguirá pasando tras el próximo prompt o tras un cambio de modelo?
Yo construyo suites de evaluación que responden a eso. Obtendrás una rúbrica escrita para tu caso de uso, un conjunto de pruebas con respuestas esperadas y, si un LLM evalúa tus resultados, una verificación de cuánta confianza merece ese juez.
Qué obtendrás:
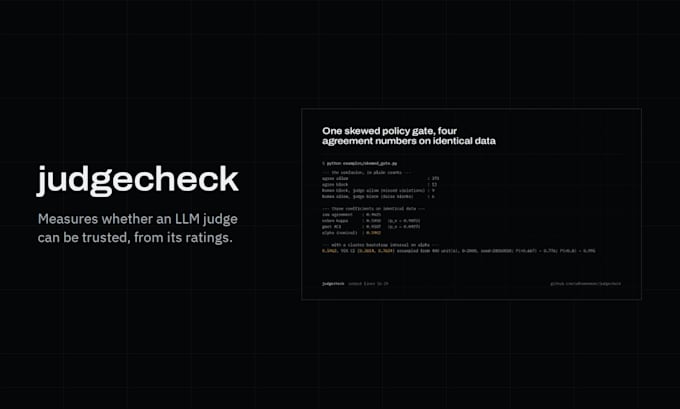
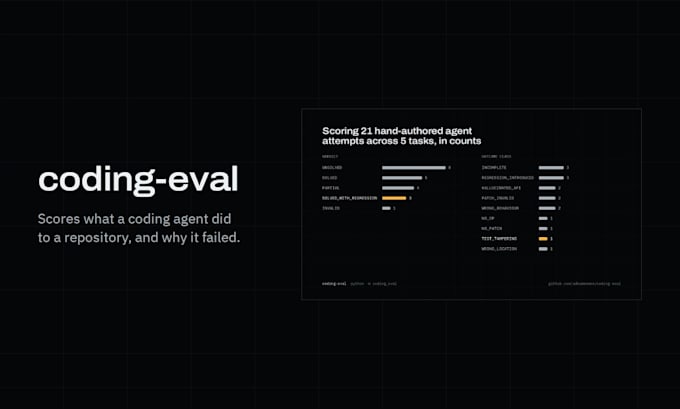
Por qué yo: construí judgecheck, un informe de fiabilidad para jueces de LLM que muestra cómo un 96% de acuerdo bruto puede ocultar puntuaciones corregidas por azar tan bajas como 0.60, y coding-eval, que reproduce intentos de agentes de codificación en un sandbox (20 de 21 éxitos reclamados; 5 exitosos). Evalúo código de modelos de frontera profesionalmente y desarrollo herramientas de rúbrica y calibración para IA clínica en árabe.
Envíame un mensaje con lo que hace la característica, algunos ejemplos de entradas y salidas, y cómo se ve una buena respuesta para ti.
AI Red Teaming and LLM Evaluation Engineer
Idiomas
Traducción automática
Traducción automática
¿Qué necesitas de mí?
Acceso al modelo o API que uses (o un archivo con salidas guardadas), algunos inputs reales de ejemplo y cualquier calificación humana que ya tengas. Si no tienes ninguna, acordamos una ronda breve de calificación juntos.