Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr
Ingeniero/a experto/a en IA y aprendizaje automático
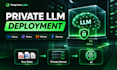
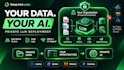
Despliego llms de código abierto de forma privada, dentro de tu propia cuenta en la nube o en tus propios servidores. Nada se envía a API de IA de terceros.
Yo ejecuto esta pila por mi cuenta: un modelo Qwen de 32B servido con vLLM, detrás de una API compatible con OpenAI, con claves API, paneles de monitoreo (Prometheus y Grafana) y todo empaquetado en una sola imagen de Docker.
Lo que obtendrás:
Opcional: un chatbot RAG que responde desde tus propios documentos y muestra sus fuentes.
Ideal para empresas que manejan datos privados o regulados (clínicas, legal, documentos internos).
Envíame un mensaje primero con tu GPU o nube y el modelo que tengas en mente, y confirmaré la configuración adecuada.
Marcos:
Scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
Tipo de datos:
Código
Lenguaje de programación:
Python
•
R
•
SQL
•
Amazon SageMaker
Herramientas:
Jupyter Notebook
•
TensorFlow
•
Amazon SageMaker
•
Colab
Traducción automática
¿Necesito mi propia GPU o cuenta en la nube?
Ambas opciones funcionan. Puedo desplegar en tu propio servidor o en una cuenta de nube que poseas (AWS, RunPod y similares). Envíame un mensaje primero y aconsejaré el tamaño de GPU para tu modelo.
¿Mis datos salen de mis servidores?
No. El modelo se ejecuta dentro de tu entorno y nada se envía a API de IA de terceros. Solo necesito acceso para la configuración, y luego puedes eliminarlo.
¿Qué modelos puedes desplegar?
Modelos de código abierto como Qwen, Llama y Gemma, con cuantización. La mejor opción depende de la memoria de tu GPU y de tu caso de uso.
¿Puede el asistente responder a partir de mis propios documentos?
Sí, esa es la opción adicional RAG. Responde desde tus archivos y muestra la fuente. Indícame los tipos de documentos y el volumen antes de pedirlo.
¿Qué necesitas de mí para empezar?
Tus detalles de GPU o nube, el modelo que tengas en mente (si alguno), y qué apps lo llamarán. Confirmaré la configuración antes de empezar.


