Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Ingeniero senior de DevOps y seguridad de redes y experto en Linux
¿Pods de Kubernetes fallando? ¿Helm con errores? ¿Red caída? Lo arreglo rápido.
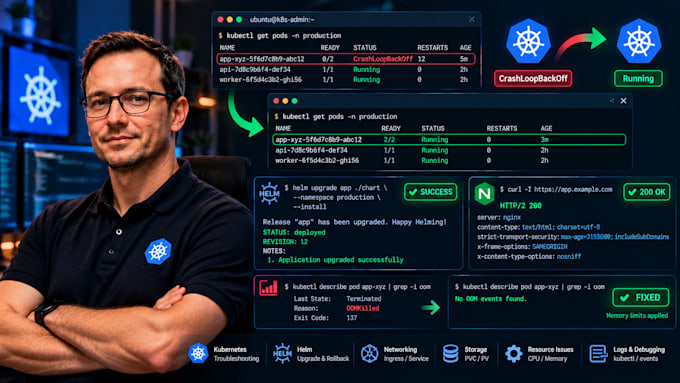
Soy Ingeniero de Plataforma/DevOps con 5+ años trabajando con K8s en producción (EKS, GKE, AKS, bare-metal). No hago conjeturas: uso un **playbook de depuración** probado (kubectl events logs metrics config) para encontrar la causa raíz en minutos.
QUE ARREGLO (Cada paquete):
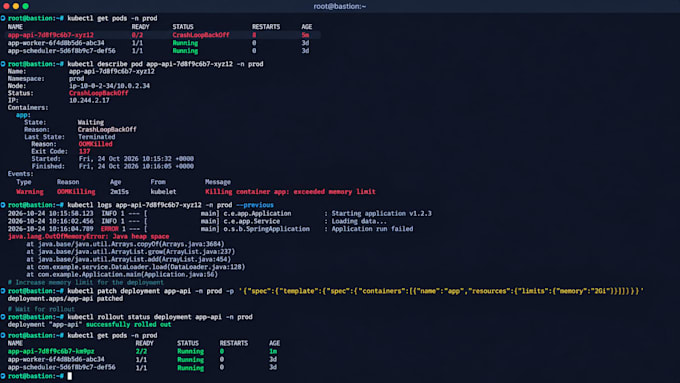
CrashLoopBackOff / OOMKilled (137) límites de memoria, filtraciones, ajuste del runtime JVM/Go
ImagePullBackOff / ErrImagePull autenticación ECR/GHCR/ACR, roles IAM, errores de etiqueta de imagen
Pending / Unschedulable quotas, selectores de nodos, taints/tolerations, vinculación de PVC
Fallos de Helm, dependencia del chart ausente, desajuste de esquema de valores, errores de plantillas, lanzamiento atascado
Networking CNI (Calico/Cilium/Flannel), CoreDNS, Service/Ingress 502/504, NetworkPolicy
Issues de ConfigMap/Secret, claves faltantes, espacio de nombres equivocado, montajes de subPath, finalizadores
Errores de probes (liveness/readiness/startup), sintonización de HTTP vs exec vs gRPC
HPA/VPA no escala, metrics-server, métricas personalizadas, métricas externas


Traducción automática
¿Cómo accedes a mi cluster de forma segura?
Proporcionas: kubeconfig con RBAC restringido (get/list/watch pods, logs, events, helm releases) O acceso a la consola en la nube (EKS: aws eks update-kubeconfig, GKE: gcloud container clusters get-credentials, AKS: az aks get-credentials). Nunca pido admin/root.
¿Y si el problema está en el código de mi aplicación?
Lo identificaré (traza de pila, código de salida, logs) y te diré exactamente qué arreglar. Si quieres que parche la imagen del contenedor, eso es un alcance distinto (envíame un mensaje).
¿Puedes arreglar charts de Helm que alguien más escribió?
Sí. Haré la depuración de la release (helm status, helm get values, helm template), arreglaré valores/dependencias/plantillas y probaré con helm upgrade --dry-run --debug.
¿Trabajas fines de semana/noches para emergencias de producción?
Sí. Envíame un mensaje con “URGENT” + zona horaria. Responderé en menos de 30 minutos durante las horas de operación (UTC+3). Recargo de emergencia: +50% (Básico), +30% (Estándar/Premium).