Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Traducción automática
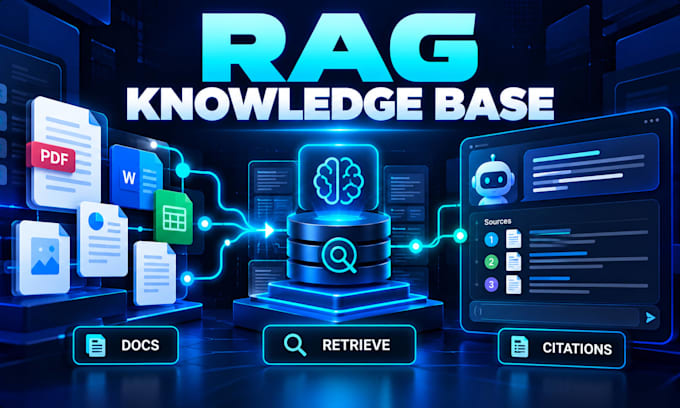
Construye una base de conocimiento AI que responda desde tus documentos con referencias a las fuentes.
Creo sistemas RAG para preguntas y respuestas de documentos y búsqueda de conocimiento interno. PDFs, DOCX, FAQs, SOPs, manuales, páginas web o bases de datos seleccionadas se procesan e indexan para que las respuestas apunten a fuentes relevantes.
LO QUE PUEDO CONSTRUIR
Uso Python, APIs de LLM y marcos RAG adecuados; la pila depende de tus datos y de tu app.
Los límites de documentos/fuentes se aplican. Migraciones grandes, grafos de conocimiento, interfaces SaaS personalizadas y permisos complejos de múltiples inquilinos requieren un alcance personalizado.
Envíanos tipos de documentos, volumen, preguntas de muestra, pila actual, roles de usuarios y resultado deseado antes de hacer el pedido.
AI Systems Specialist, Automation, Generative AI and Content Workflow for Smart
Idiomas
Traducción automática
Traducción automática
¿Puedes construir una base de conocimiento a partir de mis PDFs y documentos de negocio?
Sí. Puedo construir una base de conocimiento RAG utilizando PDFs compatibles, archivos DOCX, FAQs, SOPs, manuales, páginas web u otras fuentes acordadas. Archivos escaneados, tablas complejas y formatos inusuales pueden requerir procesamiento adicional.
¿Las respuestas incluirán citas de fuente?
Las respuestas basadas en la fuente y las citas están incluidas en el alcance acordado. El nivel de detalle de las citas depende del analizador de fuentes y de si los archivos originales exponen metadatos fiables de página o sección.
¿El sistema evita inventar respuestas?
Puedo configurar respuestas sustentadas por la recuperación y un respaldo cuando la evidencia recuperada no respalde una respuesta. Ningún sistema de IA puede garantizar cero errores, así que las pruebas representativas y las limitaciones claras son importantes.
¿Puedes arreglar un chatbot RAG existente que obtiene información incorrecta?
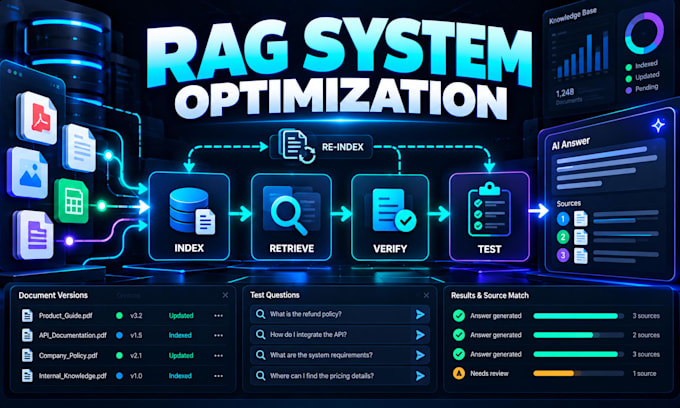
Sí. Puedo investigar la extracción, el particionado, los embeddings, la búsqueda, el filtrado, el ranking y el comportamiento de generación de respuestas. El paquete adecuado depende de si se trata de una solución contenida o de una reconstrución más amplia.
¿Se pueden actualizar los documentos sin reconstruir toda la base de conocimiento?
Sí, donde la arquitectura elegida lo permita. Puedo configurar actualizaciones de documentos y reindexación para que las nuevas versiones reemplacen contenido desactualizado en lugar de dejar información obsoleta en los resultados de recuperación.
¿Se puede usar Supabase y pgvector?
Sí, cuando sea adecuado para el proyecto. Supabase soporta búsqueda vectorial con pgvector y también búsquedas semánticas, por palabras clave e híbridas.
¿Se puede restringir el acceso a diferentes documentos?
El filtrado de acceso se puede implementar cuando sea compatible con la autenticación de la app y la arquitectura de datos. Debe aplicarse en el backend o capa de recuperación adecuada, no solo con instrucciones en el prompt.
¿Se puede migrar una base de conocimiento o un sistema Q&A existente?
Sí. Puedo revisar las fuentes actuales, el diseño de recuperación, la base de datos y las dependencias antes de proponer la migración. Migraciones grandes requieren un alcance personalizado tras evaluar el sistema actual.
¿Este Gig incluye una aplicación SaaS multitenant completa?
No. Este Gig se enfoca en el sistema de conocimiento y recuperación. Un producto SaaS completo con gestión de usuarios, aislamiento de inquilinos, facturación, paneles y desarrollo de la aplicación pertenece al Gig AI SaaS separado.
¿Qué necesitas antes de empezar?
Por favor, proporciona tu objetivo, tipos de documentos y volumen aproximado, preguntas de muestra, pila actual, integraciones necesarias, roles de usuarios y preferencias de implementación. No envíes contraseñas ni claves API secretas por chat.