Explorar las categorías
Español
$
USD
Conéctate con tu IA

Traducción automática
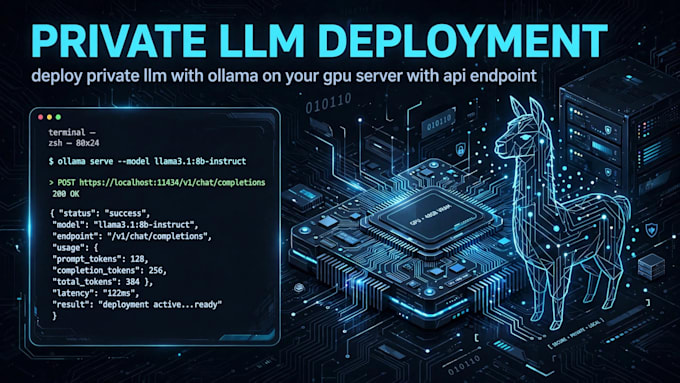
¿Quieres que tu propio modelo de IA funcione las 24 horas del día, los 7 días de la semana? Instalo Ollama (o llama.cpp) en tu instancia de nube con GPU, cargo el modelo que elijas y lo expongo como un endpoint API compatible con OpenAI, con una interfaz de chat web opcional.
Qué obtendrás:
- Ollama / llama.cpp instalados y ajustados en tu instancia GPU
- Modelo a tu elección cargado y funcionando
- endpoint API compatible con OpenAI para tus apps
- Opcional: interfaz de chat Open WebUI
- Asesoría de alquiler de GPU si aún no tienes un servidor (tú alquilas desde tu cuenta, yo recomiendo la opción más barata para tu modelo y presupuesto)
Qué necesito de ti:
- Acceso a la instancia GPU (iniciar sesión SSH)
- Qué modelo quieres ejecutar (o tu caso de uso; te recomendaré uno)
Python Developer , Web Scraping and Automation Specialist
Idiomas
Traducción automática
Traducción automática
¿Necesito mi propio servidor GPU?
Sí, alquilas la instancia de GPU en tu propia cuenta (RunPod, Vast.ai, etc.). Te recomiendo la opción más barata para tu modelo y presupuesto, luego instalo y configuro todo.
¿Qué modelos puedes desplegar?
Cualquier modelo que soporte Ollama o llama.cpp: Llama, Qwen, Mistral, DeepSeek distills y más. Dime tu caso de uso y te recomendaré uno.
¿Pueden mis apps usar el modelo vía API?
Sí, expongo un endpoint compatible con OpenAI, así que cualquier cosa que funcione con la API de OpenAI funciona con tu modelo privado.
