Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Te ayudaré a diseñar, construir, solucionar problemas y optimizar soluciones confiables de ingeniería de datos adaptadas a las necesidades de tu negocio.
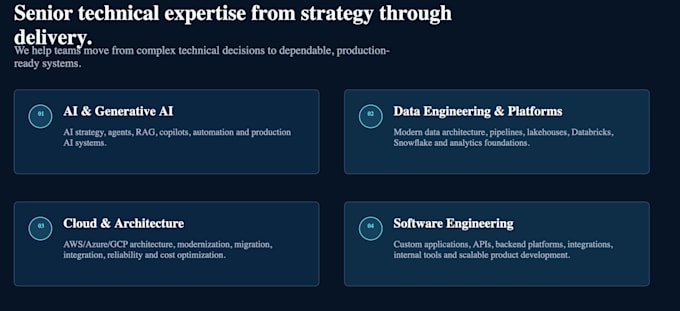
Trabajo con Databricks, PySpark, Python, SQL, Snowflake, AWS, Azure, Airflow y Delta Lake para construir pipelines escalables de ETL y ELT, modernizar flujos de trabajo heredados, mejorar la calidad de los datos y optimizar el rendimiento.
Puedo ayudarte con el desarrollo de nuevos pipelines, migraciones de datos en la nube, depuración de flujos existentes, optimización de SQL y PySpark, soluciones de data warehouse, revisiones de arquitectura y recomendaciones de mejores prácticas.
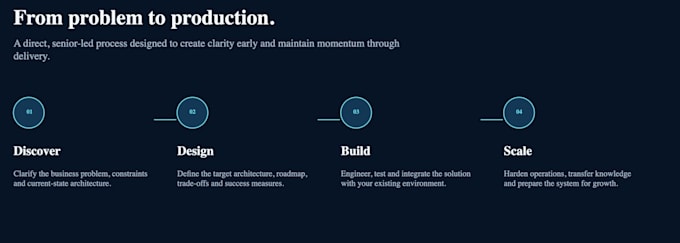
Mi objetivo es entregar soluciones limpias, prácticas y fáciles de mantener, diseñadas para escalar y que sean fáciles de entender y apoyar para tu equipo.