Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Construyo automatizaciones que ahorran tiempo y reducen el trabajo manual
Nivel 1
Ha cumplido determinados criterios de rendimiento y muestra un gran potencial en la plataforma.
Construiré un pipeline de datos automatizado que recolecta, limpia, transforma y envía tus datos empresariales a donde sea necesario.
Puedo trabajar con APIs, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, almacenamiento en la nube y otros sistemas compatibles.
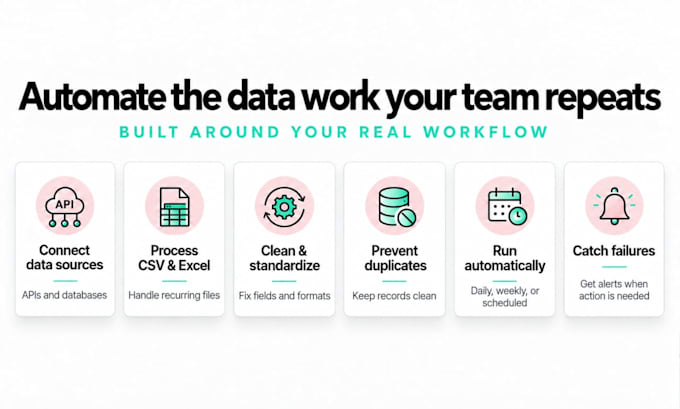
Dependiendo del paquete, tu pipeline puede incluir:
Extracción de datos y conexiones API
Limpieza, mapeo, filtrado y deduplicación
Validación y controles de calidad de datos
Ejecuciones automáticas programadas
Registro de errores y alertas de fallos
Pruebas, documentación y despliegue
Este servicio es ideal para tareas recurrentes de datos, flujos de informes, actualizaciones de bases de datos y movimiento de datos entre sistemas.
Por favor, envíame un mensaje antes de ordenar con tu fuente de datos, destino, datos de ejemplo y el proceso que quieres automatizar para poder confirmar el paquete adecuado.


Herramientas y plataformas:
Otros
Traducción automática
¿Qué es un pipeline de datos o pipeline ETL?
Es un proceso automatizado que recopila datos de una fuente, los limpia o transforma y los envía a otro sistema. Por ejemplo: API → limpiar y validar datos → PostgreSQL.
¿Con qué fuentes de datos puedes trabajar?
Las fuentes comunes incluyen APIs REST, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, almacenamiento en la nube y otros sistemas con APIs o conexiones a bases de datos accesibles.
¿Puede la canalización ejecutarse automáticamente?
Sí. Los paquetes estándar y Premium pueden incluir ejecuciones programadas, como procesamiento horario, diario o semanal.
¿Puedes limpiar, combinar o transformar mis datos?
Sí. Esto puede incluir renombrar campos, formatear fechas, filtrar registros, eliminar duplicados, unir conjuntos de datos, convertir valores y aplicar reglas de negocio.
¿Puedes conectar una API a mi base de datos?
Generalmente sí. Por favor, envíame los detalles de la API y el destino antes de ordenar para confirmar el acceso y la viabilidad.
¿Qué pasa si el pipeline falla?
Dependiendo del paquete, puedo incluir registro de errores, validación, alertas de fallos, lógica de reintentos y otras medidas de manejo de errores.
¿Recibiré el código fuente y la documentación?
Sí. El código fuente acordado y la documentación de configuración están incluidos para que no estés atado a la entrega.
¿Qué tipos de proyectos no están incluidos en estos paquetes?
Grandes almacenes de datos empresariales, arquitectura Spark o Databricks, streaming a escala Kafka, migraciones mayores y otros sistemas complejos de ingeniería de datos requieren un alcance separado y una oferta personalizada.
¿Debo comunicarme con usted antes de realizar el pedido?
Sí. Por favor, envíame un mensaje primero con tu fuente de datos, destino, datos de ejemplo y flujo de trabajo deseado para confirmar el paquete y alcance correctos.