Explorar las categorías
Español
$
USD
Conéctate con tu IA
Full Stack, Backend e Ingeniero de Datos
Convierte PDFs digitales y formularios escaneados en datos estructurados que tu equipo pueda usar.
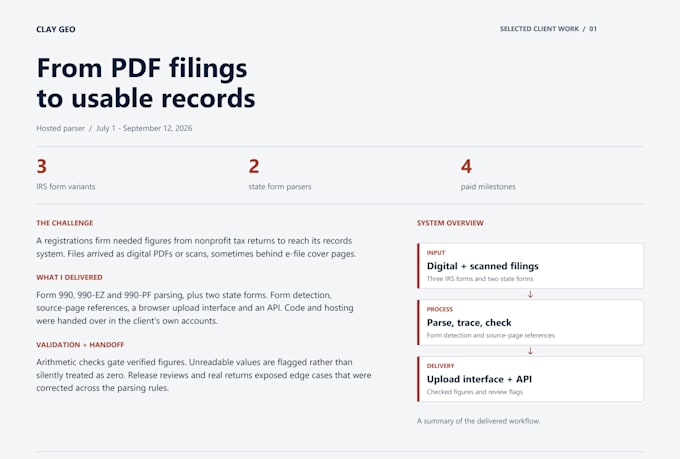
Desarrollo flujos de extracción reutilizables en Python para diseños de documentos acordados, con salida en CSV o JSON y verificaciones de campos faltantes o inválidos. Un proyecto completado para el cliente incluyó un parser de datos PDF personalizado.
El paquete Básico cubre un diseño de PDF digital. El Estándar añade OCR para documentos escaneados revisados. El Premium añade más diseños y un endpoint de API de extracción para tu aplicación. Cada paquete incluye código fuente, salida de muestra, referencias de páginas fuente, banderas de validación y notas de configuración/entrega.
Primero reviso muestras representativas, acordamos los campos y los resultados esperados, luego pruebo el parser con ese conjunto de muestras. Los resultados de OCR dependen de la calidad del documento; el flujo señala excepciones detectadas para revisión.
Los paquetes cubren los diseños declarados, el total de campos y páginas de prueba iniciales. Envía documentos de muestra y la salida deseada antes de hacer el pedido. Archivos más grandes, tablas complejas, diseños muy variables o integraciones adicionales pueden cotizarse por separado. Los costos de hosting y procesamiento de terceros son aparte.


Tecnología:
Python
Traducción automática
¿Qué cuenta como diseño o como campo?
Un diseño es una plantilla de documento consistente. Un campo es una columna de salida o una clave JSON; los límites de campos son totales según el esquema acordado. Tablas complejas o variaciones importantes de plantillas requieren revisión por separado.
¿Puedes procesar PDFs escaneados y escritura a mano?
Standard y Premium incluyen OCR para escaneos revisados. Escribir a mano, páginas degradadas y diseños muy variables requieren revisión de muestras y pueden necesitar un alcance personalizado.
¿Cómo verificas la calidad de la extracción?
Comparo la salida con valores de muestra acordados y reporto los resultados. Valores faltantes o inválidos reciben banderas de validación. El OCR puede cometer errores, así que no prometo una precisión perfecta.
¿Qué incluye la entrega y las revisiones?
Código fuente, salida de muestra, referencias a páginas fuente, banderas de validación y notas de configuración. El plan Premium añade un endpoint de API. Las revisiones refinen la extracción acordada; diseños, campos o integraciones nuevas cuestan alcance adicional.