Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Páginas web desordenadas, feeds o cuentas de Instagram convertidos en una tabla limpia y deduplicada que puedes consultar, actualizada según un horario, con un panel o API encima.
La diferencia con un scraper simple: un paso de IA lee cada elemento y llena los campos que las regex no pueden, como categoría, rango de precios, sentimiento, entidades o la fecha del evento oculta en un pie de foto. La salida se valida contra el esquema antes de tocar la base de datos, así que las respuestas mal formadas fallan ruidosamente en lugar de contaminar tus datos.
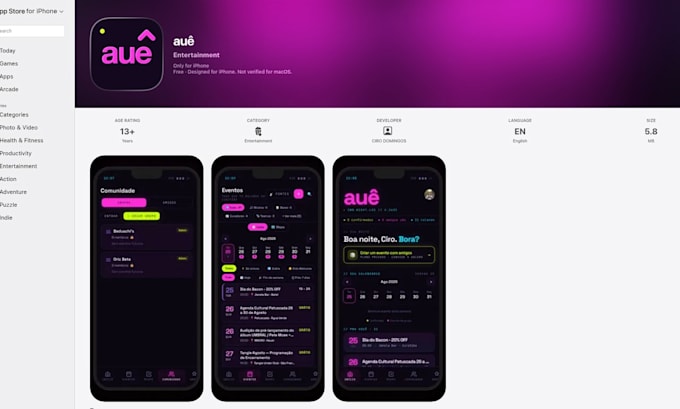
Prueba: mi app de eventos ingiere unas 80 cuentas de Instagram a través de Apify y usa Claude para extraer campos de eventos de publicaciones e imágenes todos los días. Mi scraper de marcas hace lo mismo para atributos de marcas. Ambos enlaces están en mi perfil.
Lo que obtienes: la pipeline desplegada en Railway o tu hosting, la tabla en SQLite o Postgres, un panel de Streamlit o un endpoint de FastAPI, y el costo de cada ejecución registrado.
Cómo empezamos: envía dos páginas de ejemplo y las columnas que quieres. Obtendrás una tabla de muestra de 100 filas antes de la ejecución completa.
No incluido: sitios que prohíben scraping en sus términos, logins, captchas.
Traducción automática
¿Puede ejecutarse en mi servidor?
Sí, o en Railway bajo tu cuenta.
¿Cuánto cuesta operar?
Generalmente menos de 20 dólares al mes; cada ejecución registra su costo.