Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Limpieza de datos, web scraping y automatización de hojas de cálculo
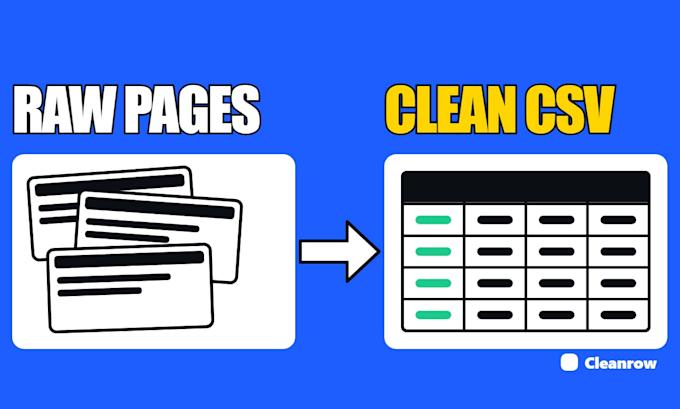
Obtienes un conjunto de datos limpio en CSV y JSON de cualquier sitio web público, generalmente en 48 horas.
Indícame la URL y los campos que necesitas, como nombre del producto, precio, valoración y enlace, y te devolveré un conjunto de datos estructurado además de un informe de cobertura que muestra exactamente qué páginas se visitaron y qué tan completo está cada campo.
Cómo funciona: un navegador sin interfaz carga cada página como lo haría un visitante real, por lo que los listados renderizados con JavaScript funcionan. Se revisa y respeta el archivo robots.txt antes de cada solicitud. La paginación se sigue automáticamente hasta el límite que establezcas, con una pausa deliberada entre páginas.
Recibirás dataset.csv, dataset.json y coverage.md, que lista cada página visitada con su estado y cantidad de registros, además de un porcentaje de completitud por campo para que puedas ver qué es lo que realmente no tenía la fuente.
Sólo páginas públicas. No extraigo detrás de logins o muros de pago, no evado CAPTCHAs ni límites de velocidad, y no recopilo datos personales de contacto como listas de correos electrónicos o teléfonos. Por favor, no hagas pedidos de esos.
Este es un flujo de trabajo asistido por IA con revisión humana antes de la entrega. Envíame primero la URL y te diré honestamente si se puede hacer.


Tecnología:
Python
•
Beautiful Soup
•
Playwright
•
Pandas
Técnica:
Automatizado
Traducción automática
¿Puedes hacer scraping en un sitio que requiere login?
No. Este servicio cubre solo páginas accesibles públicamente. Cualquier cosa detrás de un login, muro de pago o CAPTCHA está fuera del alcance y lo rechazaré en lugar de intentarlo.
¿Puedes crearme una lista de correos electrónicos o números de teléfono?
No. No recolecto datos de contacto personales. Esto viola los términos de Fiverr y la ley de privacidad en la mayoría de los países. Datos públicos de listados comerciales como nombres de empresas, categorías, precios y URLs públicos están bien.
¿Qué pasa si el sitio bloquea el scraping en robots.txt?
Reviso robots.txt antes de cada solicitud y lo respeto. Si la ruta está prohibida, te lo diré antes de comenzar y cancelaré el pedido, en lugar de buscar formas de evadirlo.
Los datos que necesito están en la página de cada artículo, no en la lista. ¿Puedes obtenerlos?
Sí, esa es la categoría Premium. La lista se recopila primero y luego se visita cada página de detalles y se fusiona en la misma fila. Dime qué campos están en la página de detalles.
¿Usas IA para esto?
Sí, este es un flujo de trabajo asistido por IA y un humano revisa cada entrega antes de enviarla. El conjunto de datos se produce solo para tu pedido.