Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Conversión de PDF a texto, bibliotecas offline buscables
Tus contratos y documentos técnicos permanecen en tu propia máquina. Encontrar una cláusula
significa abrir archivos uno por uno y todas las herramientas en la nube que resuelven esto envían tus
archivos a los servidores de otra persona.
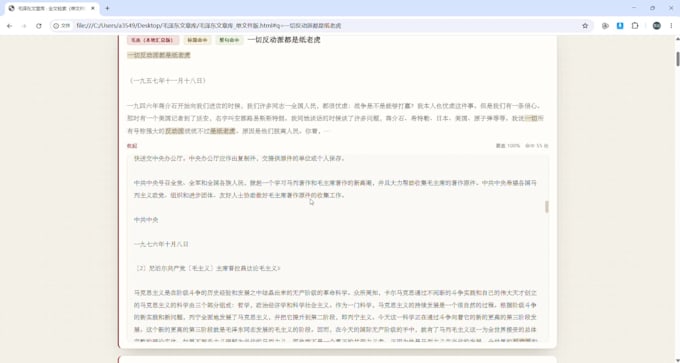
Yo construyo lo contrario: una biblioteca searchable que funciona completamente en tu computadora.
LO QUE OBTIENES
Sin instalación. Sin Python. Sin GPU. Sin línea de comandos. Un archivo .html, doble clic y busca. Sin cuenta, sin internet.
Cada resultado muestra el documento fuente y la página de donde proviene.
Encabezados en ejecución, números de página y líneas duplicadas son eliminados.
LO QUE NO HACE
- Búsqueda por palabras clave, no semántica: los códigos exactos funcionan bien, "encontrar la cláusula sobre pago atrasado" funciona menos bien.
- Las páginas escaneadas necesitan OCR. Escaneos limpios están bien, la escritura a mano a menudo no.
- El texto OCR puede contener errores. Bueno para buscar, no para citar como autoridad.
EXTRAS
- Conectividad con fuentes de datos: conecto fuentes adicionales (base de datos, nube,
sitio web) en la misma biblioteca.
- Integración con API: añade una interfaz de preguntas y respuestas que usa tu propia clave API.
Tus documentos aún nunca salen de tu máquina.
- Incluye código fuente: la pipeline en Python que construye la biblioteca, para que puedas
reconstruirla tú mismo más tarde.


Tecnología:
Excel
•
Python
•
Otros
Traducción automática
¿Necesito alojarlo o pagar una suscripción?
No. Es un solo archivo .html que se abre sin conexión. Nada se sube a ningún servidor.
¿Puedes manejar chino?
Sí. He creado una biblioteca searchable de más de 5,000 artículos chinos (9.6 millones de caracteres) a partir de PDFs escaneados y páginas web. Documentos en chino, inglés y japonés están bien. (Soy chino, así que esta parte es fácil).
¿Qué tipos de archivos acepta?
PDFs basados en texto, PDFs escaneados (OCR), archivos Word y otros archivos de Office, texto plano y páginas web. Envíame una muestra y te confirmaré antes de que hagas el pedido.
¿Realmente es offline? ¿A dónde van mis documentos?
A ningún lado. Todo se construye en tu máquina y se entrega como un solo archivo .html. Sin cuenta, sin subir archivos y sin internet para buscar — puedes desconectar el cable de red y aún así funciona.
¿Puede responder preguntas en lenguaje sencillo, como un chatbot?
No en los paquetes estándar — esos te ofrecen búsqueda por palabras clave. Si quieres una interfaz de preguntas y respuestas, añade el extra "API integration": usa tu propia clave API y mantiene tus documentos en tu máquina.
¿Qué pasa con los documentos escaneados y la escritura a mano?
Las páginas escaneadas se procesan con OCR. Los escaneos limpios y de alta resolución funcionan bien. La escritura a mano a menudo no, y el texto OCR puede contener errores — es útil para buscar, pero no para citar.
¿Puedo agregar más documentos después?
Sí. Con el extra "Include source code" obtienes la pipeline en Python y puedes reconstruir la biblioteca tú mismo cada vez que añades archivos. Sin él, envíame un mensaje y te cotizaré un trabajo de seguimiento más pequeño.
¿Qué pasa si mi conjunto es mayor a 3,000 páginas o combina PDFs y páginas web?
Envíame un mensaje antes de ordenar. Revisaré tus archivos y te enviaré una oferta personalizada.