Explorar las categorías
Español
$
USD
Conéctate con tu IA
Desarrollador backend y especialista en IA local: Laravel, Python, RAG
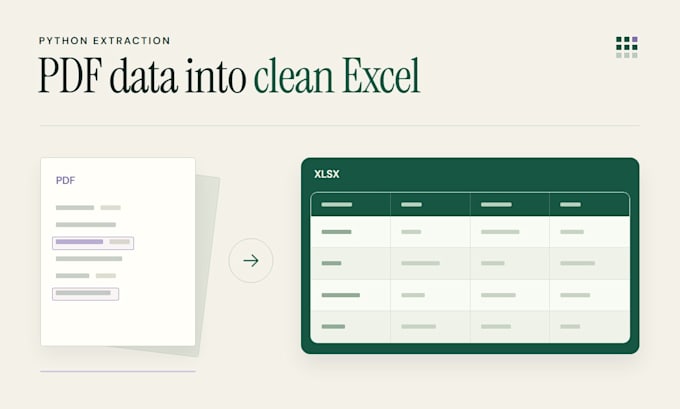
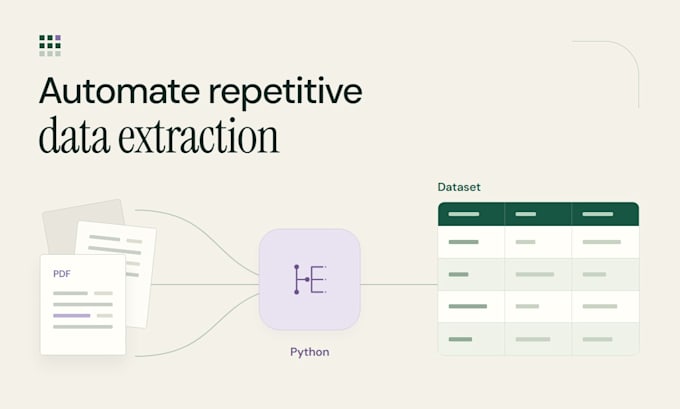
Convierte informes repetitivos de PDF en un archivo limpio de Excel o CSV que realmente puedas usar.
Construyo flujos de extracción en Python para PDFs legibles basados en texto con diseños consistentes. Tú defines las columnas; yo mapeo los campos acordados, proceso el lote incluido y verifico la estructura de salida.
El plan Básico cubre hasta 20 páginas y un diseño. Standard añade hasta 70 páginas, dos diseños y un script de Python reutilizable. El plan Premium cubre hasta 150 páginas y tres diseños, con verificaciones de validación acordadas y documentación de ejecución. Se aplican límites de campo, archivo y fila.
Recibes una salida estructurada, un breve resumen de extracción y una lista clara de todo lo que necesita revisión. Standard y Premium también incluyen el script fuente. Las salidas se verifican contra el esquema acordado; la extracción de PDF aún puede requerir revisión humana.
Por favor, envíame un mensaje con una muestra redactada de cada diseño y tus columnas objetivo antes de hacer el pedido. Escaneos, escritura a mano, OCR avanzado, plantillas cambiantes y reglas de negocio complejas requieren una evaluación separada.
Tecnología:
Excel
•
Hojas de cálculo de Google
•
Python
Traducción automática
¿Qué PDFs puedes trabajar?
Los PDFs legibles basados en texto con etiquetas de campos o estructuras de tablas consistentes son los más adecuados. Envíame una muestra redactada de cada diseño antes de pedir para poder evaluar la extracción y confirmar el paquete.
¿Es esto entrada de datos manual?
El servicio utiliza Python para extraer estructuras de datos repetibles. Está pensado para formatos de documentos recurrentes, con un esquema definido y salida verificada. Transcripción manual de documentos variados no está incluido en esta oferta.
¿Qué cuenta como un diseño diferente?
Un diseño usa las mismas etiquetas de campo, posiciones de campo y estructura de tabla. Valores diferentes o fechas suelen estar bien. Un cambio de estructura de encabezado, campo movido o nueva disposición de tablas puede requerir una lógica de extracción separada y contarse como otro diseño.
¿El resultado será 100% preciso?
No se garantiza un porcentaje de exactitud. Reviso el salida representativa, verifico la estructura acordada y señalo excepciones detectadas. Los PDFs pueden contener texto ausente o formatos inusuales, así que deberías revisar los valores marcados antes de confiar en los datos.
¿Puedes manejar PDFs escaneados o escritura a mano?
Los escaneos, PDFs con solo imágenes, escritura a mano, OCR avanzado y documentos de baja calidad requieren una evaluación separada y una cotización personalizada. No están incluidos en estos paquetes.