Optimizaré la infraestructura de llm, desplegaré vllm y recortaré los costos de GPU en la nube

B
bipro515
B
bipro515
Biprojit Adhika
Parte de la información se ha traducido automáticamente.

Acerca de este Servicio

Traducción automática

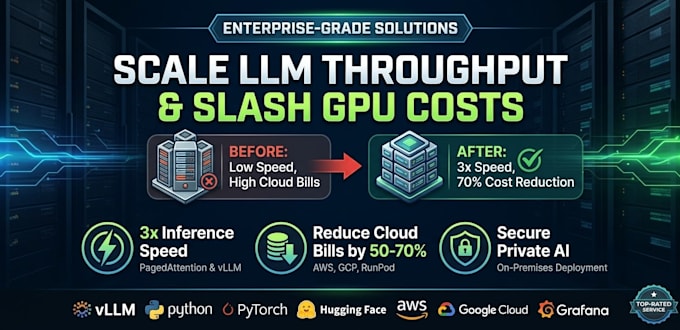
¿Las facturas mensuales de GPU de AWS, GCP o RunPod se te están yendo por las nubes? ¿Tu rendimiento de LLM se ve limitado por la latencia?

​Soy un Especialista en Infraestructura de LLM y Arquitecto de IA Privada. Ayudo a empresas de IA y a equipos de ingeniería a optimizar implementaciones de LLM de código abierto (Llama 3, Mistral, DeepSeek) para maximizar el rendimiento de las solicitudes y reducir drásticamente los costos de infraestructura en la nube.

​ Lo que puedo hacer por ti:

  • ​Despliegue vLLM y PagedAttention: Incrementa el rendimiento de solicitudes en 3x-4x frente a las pipelines básicas de Hugging Face.
  • ​Cuantización de modelos (AWQ / GPTQ / FP8): Reduce el uso de VRAM hasta un 60-70% con pérdida mínima de precisión.
  • ​Optimización de costos en la nube de GPU: Disminuye el gasto mensual en GPU en AWS/GCP/RunPod mientras atiendes a más usuarios concurrentes.
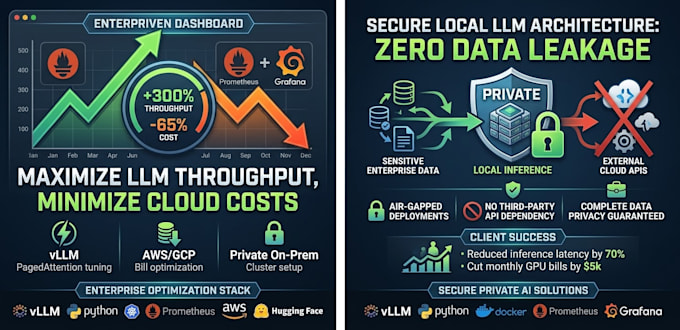
  • ​IA Privada y Migración On-Premises: Despliega LLMs locales seguros y desconectados de internet en tu infraestructura para garantizar la privacidad total de los datos.
  • ​Monitoreo y Analítica: Configura dashboards de Prometheus + Grafana para rastrear latencia, velocidad de generación de tokens (tokens/seg) y uso de GPU en tiempo real.

​️ ¿Por qué elegirme?

  • ​Alto ROI: Mis configuraciones de optimización de infraestructura se pagan solas dentro del primer mes de ahorros en la nube del servidor.
  • ​Entrega lista para producción: Entornos limpios con Docker y automatización

Conoce a Biprojit Adhika

Biprojit Adhika

Principal Architect LLM Infrastructure Private AI

  • DeBangladesh
  • Miembro desdeoct 2026
  • Idiomas

    Inglés
I am a high-impact Principal AI Infrastructure Architect specializing in LLM performance optimization and zero-data-leakage Private AI architecture. I have a proven track record in slashing enterprise hosting costs by 50%–80% using advanced quantization and high-speed inference engines. I expertize in orchestrating resilient Linux GPU clusters and localized vector search infrastructure.

Traducción automática

Mi porfolio