Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Agencia
Traducción automática
AJUSTE FINO DE LLM PERSONALIZADOS | IA PRIVADA
Los modelos de IA genéricos pueden inventar hechos del dominio, perder el contexto de tu negocio o generar preocupaciones de privacidad.
LA SOLUCIÓN
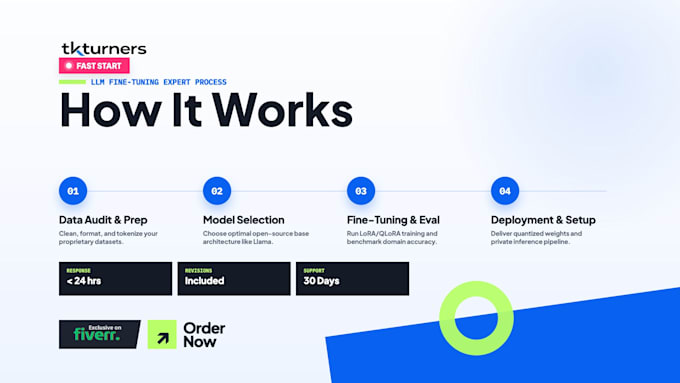
Ajustamos modelos open-source como Llama 3, Mistral y Qwen en tus datos propios, flujos de trabajo y tono de marca para un rendimiento especializado, manteniendo tu información privada.
POR QUÉ TKTURNERS
Ingeniería de IA de pila completa con LoRA/QLoRA, curación experta de conjuntos de datos, cumplimiento de NDA y manejo seguro y aislado de datos.
LO QUE ENTREGAMOS
GARANTÍA DE CALIDAD
Iteramos hasta que el modelo cumpla con las métricas de referencia acordadas.
AUDITORÍA GRATUITA
Envía un mensaje antes de ordenar para una auditoría gratuita de datos y una hoja de ruta de arquitectura de IA.

Agencia
20 empleados
Idiomas
Traducción automática

MEETOVO

S&D Moving

Empowering Confident Youth
Education Services
Traducción automática
¿Por qué debo enviarle un mensaje antes de realizar un pedido?
El ajuste fino depende mucho del tamaño, formato y caso de uso de tu dataset. Primero verificamos la viabilidad de tus datos y seleccionamos la arquitectura open-source más rentable.
¿Cómo aseguras que mis datos empresariales propios permanezcan confidenciales?
Tus datos son estrictamente tuyos. Ejecutamos NDA empresariales, usamos entornos de computación privados y aislados, y eliminamos todos los datos de entrenamiento inmediatamente después de finalizar el proyecto.
¿Con qué modelos open-source puedes hacer ajuste fino?
Trabajamos con los principales modelos open-source como Llama 3/3.1, Mistral/Mixtral, Qwen 2.5, Phi-3, Gemma 2 y modelos especializados de código/embedding.
¿Quién cubre los costos de GPU y entrenamiento en la nube?
Los costos de computación (por ejemplo, RunPod, Lambda Labs, AWS EC2 o Colab Pro) los paga directamente el cliente. Optimizamos el entrenamiento usando QLoRA para mantener los costos de computación generalmente entre 10 y 50 dólares.
¿Qué formato de datos necesito proporcionar?
Aceptamos JSONL, CSV, texto sin formato, Markdown, PDFs o pares instrucción-respuesta. Si tus datos son no estructurados, podemos limpiarlos y formatearlos en conjuntos de datos de alta calidad para instrucciones.
¿En qué formato se entregará mi modelo ajustado?
Proporcionamos pesos de adaptadores PEFT/LoRA, safetensors fusionados, archivos GGUF cuantizados para Ollama/LM Studio, o un servicio vLLM/FastAPI en contenedor.
¿Qué acceso necesitas de mi parte para comenzar a trabajar?
Necesitamos tu muestra o dataset completo y acceso a tu instancia de GPU en la nube preferida (RunPod, Hugging Face o AWS) o entorno local.
¿Qué cubren las revisiones?
Las revisiones incluyen ajustes de hiperparámetros (tasa de aprendizaje, epochs, rango), re-evaluación en conjuntos de validación personalizados y conversión de formato de exportación.
¿Puedes integrar el modelo ajustado en mi aplicación web o API existente?
Sí. Como agencia de ingeniería de pila completa, construimos microservicios en FastAPI, contenedores Docker y frontends en Next.js/Node.js para servir tu modelo de manera fluida.
¿Ofrecen soporte y mantenimiento post-entrega?
Sí. La categoría Premium incluye 14 días de soporte. También ofrecemos paquetes de mantenimiento continuo para reentrenamiento, actualizaciones de datasets y escalado de servidores.