Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
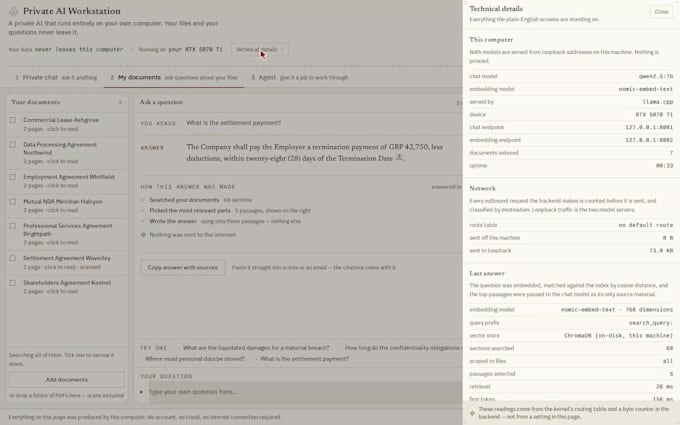
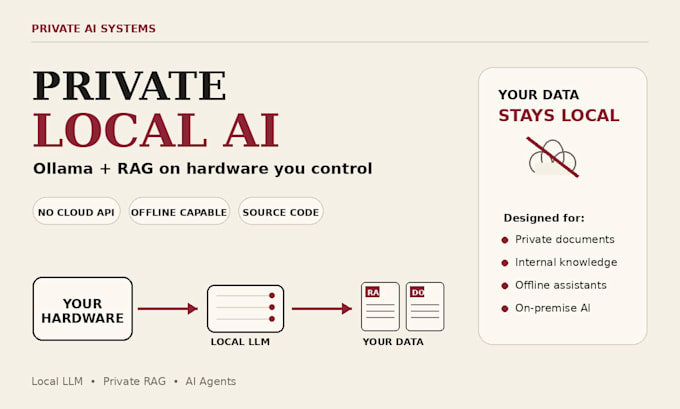
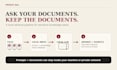
Ejecuta un LLM privado local en hardware que controlas sin enviar prompts, documentos ni datos sensibles a APIs externas de modelos.
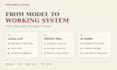
Construyo sistemas de IA locales con Ollama, llama.cpp, RAG, bases de datos vectoriales y flujos de trabajo de agentes personalizados para empresas y equipos que necesitan privacidad.
LO QUE PUEDO IMPLEMENTAR
ADECUADO PARA
Bases de conocimiento internas, documentos confidenciales, operaciones legales/financieras, investigación privada, asistentes offline y equipos que evitan costos recurrentes de API de IA en la nube.
Tu sistema puede configurarse para realizar inferencias y recuperación de documentos completamente en tu máquina o red privada.
Envíame un mensaje antes de ordenar con tu sistema operativo, CPU, GPU/VRAM, RAM y caso de uso deseado para que pueda confirmar el modelo y paquete adecuados.
Local AI Developer
Idiomas
Traducción automática
Traducción automática
¿Necesito una computadora potente para esto?
Depende del modelo y la carga de trabajo. Se recomienda una GPU NVIDIA dedicada con suficiente VRAM para una inferencia más rápida, pero los modelos más pequeños también pueden funcionar en CPUs y Macs con Apple Silicon. Envíame tu CPU, GPU/VRAM, RAM y caso de uso y te puedo recomendar una configuración realista.
¿Esto requiere una conexión a internet activa para funcionar?
No se necesita conexión a internet para el sistema local principal después de instalar los modelos y dependencias necesarios. Las integraciones externas opcionales pueden requerir acceso a la red.
¿Se enviarán mis prompts y documentos a una API externa de IA?
La implementación puede configurarse para que la inferencia y recuperación de documentos se ejecuten en tu propia máquina o red privada sin enviar prompts o documentos a APIs externas de modelos.
¿Qué documentos puede usar el sistema RAG?
Las fuentes típicas incluyen PDF, DOCX, TXT, CSV y contenido estructurado de bases de conocimiento. Pregunta primero si tienes PDFs escaneados, formatos inusuales o una base de datos grande existente.
¿Recibo el código fuente y los archivos de configuración?
Sí, para código personalizado creado para tu proyecto. El software y los modelos de terceros siguen sujetos a sus propias licencias. También incluyo la configuración acordada y la documentación de entrega.
¿Puedes hacerlo completamente air-gapped?
Sí, cuando el software seleccionado, los archivos de modelo y tu entorno soporten una implementación air-gapped. Dímelo antes de ordenar para que el alcance incluya la gestión de dependencias offline.
¿Puedes instalarlo en Windows, Linux, macOS o en un servidor?
Sí, dependiendo de tu hardware y la pila seleccionada. Sistemas con Apple Silicon, GPU NVIDIA, máquinas solo con CPU y configuraciones VPS o servidor pueden ser soportados con diferentes opciones de modelos.
¿Incluye ajuste fino o entrenamiento del modelo?
No, no por defecto. Este Gig se enfoca en despliegue, RAG, integración y flujos de trabajo con agentes locales. El ajuste fino es un alcance separado y debe discutirse antes de ordenar.
¿Cómo lo despliegas en mi hardware?
Proporciono los archivos del proyecto y los pasos de despliegue y puedo guiar la configuración a través de la comunicación en Fiverr. El método exacto depende de tu entorno y restricciones de acceso.
¿Qué debo enviar antes de realizar el pedido?
Tu sistema operativo, modelo de CPU y GPU y VRAM, RAM, almacenamiento disponible, caso de uso, tipos de documentos o datos, interfaz preferida y si necesitas operación offline o air-gapped.