Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
Entreno modelos LoRA personalizados que reproducen de manera confiable un personaje, producto o estilo específico en imágenes y videos generados por IA.
Ya sea que necesites un personaje consistente para una serie de imágenes, un modelo de producto para visuales de marketing, o un estilo artístico específico que quieras replicar, manejo todo el proceso: preparación del conjunto de datos, etiquetado, entrenamiento y regularización para mantener la precisión del modelo sin filtrarse en generaciones no relacionadas.
Trabajo con SDXL y FLUX.2, ambos con licencia comercial, por lo que no hay restricciones sobre lo que hagas con los resultados.
Cada LoRA se prueba en varias escenas y prompts nuevos antes de entregarlo, no solo con las fotos de entrenamiento, para que puedas estar seguro de que realmente generaliza.
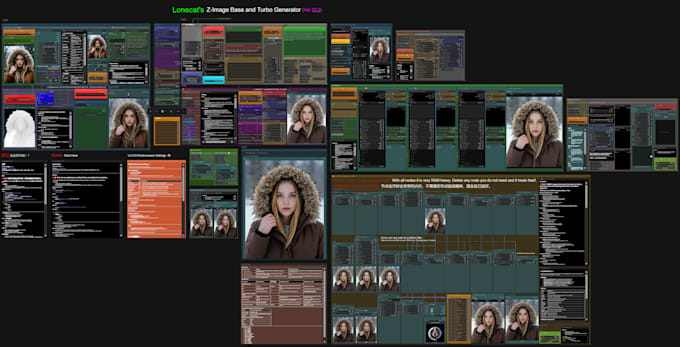
Los pedidos premium incluyen un flujo de trabajo en ComfyUI listo para usar, construido específicamente alrededor de tu modelo, para que puedas comenzar a generar de inmediato sin configurar nada tú mismo.
Envíame tus imágenes de referencia y una descripción de lo que necesitas, y te diré honestamente qué es realista antes de que hagas tu pedido.
Informa al freelancer cualquier preferencia o inquietud que tengas con respecto al uso de herramientas de IA en la finalización y/o entrega de tu pedido.
Generative AI Specialist, ComfyUI and LoRA Training
Idiomas
Traducción automática
Traducción automática
¿Qué imágenes necesito proporcionar?
Para una persona, personaje u objeto — al menos 15-20 fotos claras, en alta resolución, desde diferentes ángulos, con distintas iluminaciones y fondos. Para un estilo — alrededor de 30-50 imágenes de ejemplo. Cuanta más variedad haya en tus fotos, más flexible y confiable será el LoRA.
¿En qué plataforma podré usar el LoRA?
Recibirás un archivo estándar .safetensors que funciona en ComfyUI, Automatic1111 y la mayoría de las herramientas de Stable Diffusion / FLUX. Si necesitas ayuda para configurarlo, el paquete Premium incluye un flujo de trabajo en ComfyUI listo para usar.
¿Cuánto tiempo tarda realmente el entrenamiento?
El entrenamiento en sí suele tomar entre 1 y 3 horas, dependiendo del modelo. La mayor parte del tiempo de entrega se dedica a preparar el conjunto de datos, etiquetarlo y generar resultados de muestra limpios, no al proceso de entrenamiento en sí.
¿El LoRA funcionará en escenas diferentes a mis fotos de entrenamiento?
Sí, ese es el objetivo. Pruebo cada LoRA con prompts que describen nuevos entornos, iluminaciones y acciones que tus fotos de entrenamiento no incluyen, para asegurar que generalice en lugar de solo repetir las imágenes de entrenamiento.
¿Puedo usar el LoRA comercialmente?
Sí. Entreno en modelos base con licencia Apache 2.0 (SDXL, FLUX.2 Klein), por lo que no hay restricciones en el uso comercial de lo que generes.
¿Y si el primer resultado no es lo que esperaba?
Para eso sirven las revisiones, incluidas en todos los paquetes. Envíame comentarios específicos (qué está mal, qué muestra) y volveré a entrenar o ajustar según sea necesario.