Explorar las categorías
Español
$
USD
Conecta tu IA a Fiverr

Traducción automática
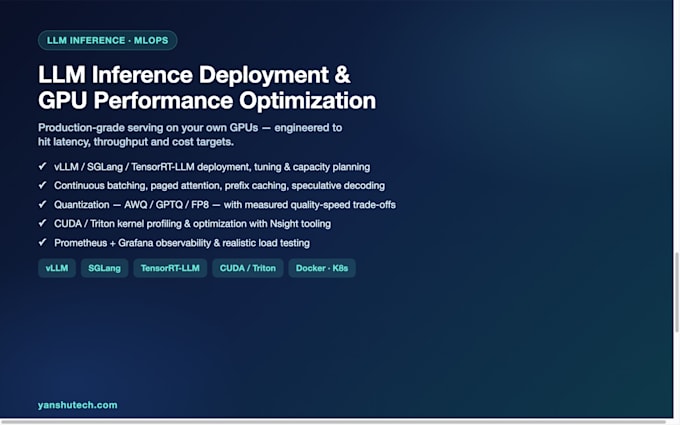
Acuesta la latencia de tu modelo y aumenta el rendimiento con números medibles.
Trabajos típicos:
- Sirvo tu modelo con vLLM, SGLang o TensorRT-LLM, ajustado a tu flota de GPUs
- Agrupamiento continuo, atención paginada, caché de prefijo, decodificación especulativa
- Cuantización (AWQ / GPTQ / FP8) con una comparación calidad-velocidad que puedes verificar
- Perfilado CUDA / Triton con Nsight para encontrar realmente los cuellos de botella
- Empaquetado con Docker / Kubernetes, paneles de Prometheus + Grafana, pruebas de carga realistas
Lo que obtienes: configuraciones de servicio, resultados de benchmarks (latencia p50/p95, tokens/seg, coste por 1M tokens), un informe de pruebas de carga y un breve runbook para que tu equipo opere.
Lo que NO está incluido: hardware de GPU y gasto en la nube, licencias de modelos, servicios de terceros de pago, soporte 24/7. Todo se ejecuta en tu infraestructura.
17 años de experiencia en sistemas e ingeniería ML; despliego modelos en GPUs de clientes como parte de mi trabajo diario en productos.
Envíame el tamaño de tu modelo, tipo de GPU y números objetivo antes de hacer el pedido.
Idiomas
Traducción automática
Traducción automática
¿Funcionará esto con mi GPU y mi modelo?
Sí: A100, H100, L40S, RTX 4090 y cualquier modelo de Hugging Face. Hago el benchmark en tu hardware real antes de ajustar, para que obtengas números reales para tu configuración.
