Explorar las categorías
Explora
Fiverr Pro
Español
$
USD
Desarrollador web full stack: WordPress, OCR, integración de API, sitios web de péptidos
¿Necesitas automatizar el seguimiento visual, extraer datos o lanzar una app de IA?
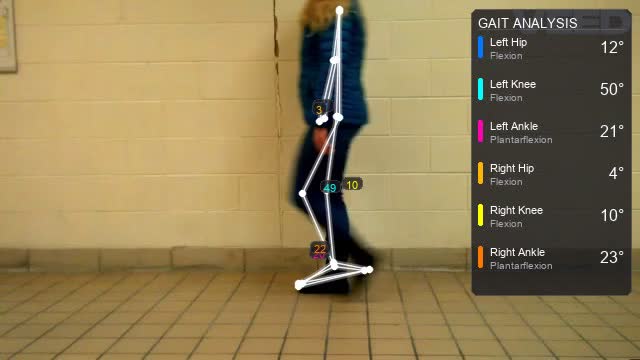
El análisis manual de videos y el manejo de documentos te hacen perder tiempo. Construyo sistemas de visión por computadora con IA y OCR de alto rendimiento para resolver tus cuellos de botella y convertir datos visuales en insights accionables.
Ya sea que necesites una app de visión por computadora o detección de objetos independiente o una canalización de extracción de datos, entrego software robusto, listo para desplegarse y adaptado a tu flujo de trabajo.
PROBLEMAS QUE RESUELVO:
TECNOLOGÍAS Y HERRAMIENTAS:
¿POR QUÉ ELEGIR ESTE GIG?
Envíame un mensaje antes de ordenar para discutir tu dataset!
Traducción automática
¿Qué necesito proporcionar para comenzar a crear mi app de visión por computadora o detección de objetos?
Por favor, proporciona tu dataset (imágenes, videos o escaneos de documentos) y una explicación clara de qué objetos o textos quieres que el sistema de visión con IA y OCR rastree o extraiga. Si aún no tienes datos, puedo ayudarte con la recopilación y configuraciones personalizadas de frameworks.
¿Qué frameworks y modelos de deep learning utilizas para el desarrollo?
Principalmente escribo scripts limpios en Python usando OpenCV para transmisiones en vivo, junto con PyTorch y TensorFlow para entrenamiento de modelos. Para alta velocidad y precisión, implemento arquitecturas de última generación como YOLOv8 y YOLOv11 para garantizar resultados de primera.
¿Tu sistema de OCR puede manejar texto manuscrito o documentos complejos?
Sí, el sistema de OCR inteligente está configurado con motores robustos (como Tesseract, EasyOCR o APIs de visión en la nube) adaptados para leer diseños de varias columnas, facturas digitales y campos de texto complejos, convirtiendo archivos en datos estructurados y buscables.
¿La aplicación final se ejecutará localmente o puede desplegarse en la nube?
¡Ambas! Dependiendo de tus necesidades, puedo entregarte una solución como una herramienta ligera de escritorio, empaquetarla en contenedores Docker para servidores en la nube (AWS/GCP), o construir una interfaz de app web de IA totalmente interactiva usando herramientas modernas de dashboards en Python como Streamlit.
¿Cómo garantizas la precisión del seguimiento de objetos y la segmentación de imágenes?
Cada canalización pasa por pruebas de validación estrictas usando métricas personalizadas de evaluación de machine learning. Ajusto rigurosamente los umbrales de confianza, elimino falsos positivos y perfecciono las máscaras de segmentación hasta que el sistema alcance la precisión requerida en producción.