Explorar las categorías
Explora
Fiverr Pro
Español
$
USD

Traducción automática
Autoalojaré tu LLM de forma privada en tu propio servidor o en la nube
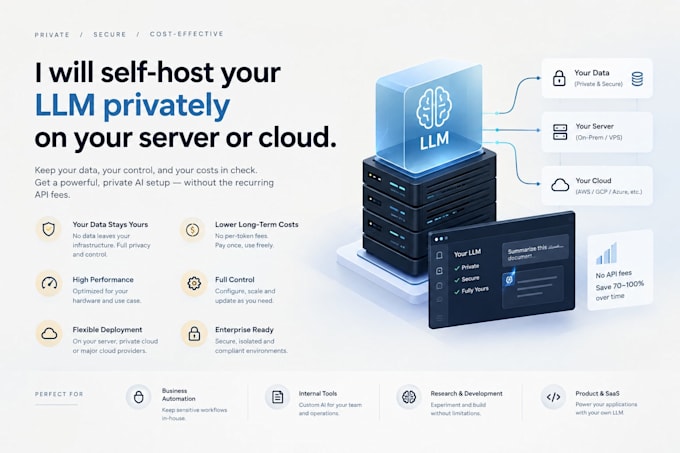
Ejecutar tu LLM a través de una API de terceros significa que tus solicitudes y datos pasan por los servidores de otra persona. Si necesitas privacidad de datos, costos predecibles o un modelo offline/air gapped, el autoalojamiento es la solución. Lo configuro de principio a fin.
Implemento modelos de peso abierto (Llama, Mistral, Qwen, DeepSeek o tu modelo ajustado) en tu propio VPS, servidor dedicado o instancia de GPU en la nube (AWS, Vultr, RunPod, Lambda Labs), y los expongo mediante un endpoint API compatible con OpenAI que puedes conectar directamente a tu app.
Lo que obtienes:
He configurado infraestructura de producción en AWS (ECS, EC2, IAM) y he gestionado cargas de trabajo con Kubernetes montado en GPU. Antes de esto, no es mi primer servidor.
AI Engineer and Automation Specialist I LangChain, RAG I React, Node, DevOps
Idiomas
Traducción automática
Traducción automática
¿Necesito mi propia GPU?
No — puedo ayudarte a provisionar una instancia de GPU en la nube si no tienes una (el costo es aparte del precio por gigabyte).
¿Puedes hacer fine-tuning del modelo?
Eso es un servicio aparte — este gig cubre el despliegue/hosting de un modelo existente o de peso abierto.
¿Mis datos son realmente privados?
Sí — una vez desplegado, toda la inferencia se realiza en tu infraestructura; no se envía nada a una API de terceros.
